«گنجور اندروید غیررسمی»؛ اپ اندرویدی با نام گنجور با رابط فارسی، اردو و انگلیسی

«گنجور اندروید» برنامه‌ای متن‌باز، بدون تبلیغ و غیررسمی برای خواندن گنجور روی گوشی و تبلت اندرویدی است؛ ساختهٔ محمد انس رشید از لاهور پاکستان.

محمد انس رشید از کاربران قدیمی گنجور و اهل لاهور پاکستان است. او می‌گوید مدتی دنبال یک برنامهٔ گنجور برای اندروید گشته و برنامه‌هایی که پیدا کرده یا تبلیغ داشته‌اند یا تجربهٔ کاربری خوبی نداشته‌اند؛ برای همین تصمیم گرفته خودش یکی بسازد و کدش را برای همه باز بگذارد. نتیجهٔ این تلاش «گنجور اندروید» است:

github.com/anas-rashid/ganjoorandroid


یک نکتهٔ مهم پیش از شروع

این برنامه ساختهٔ گنجور نیست و تیم گنجور آن را اجرا یا پشتیبانی نمی‌کند. سازنده هم در توضیح پروژه همین را نوشته است. اگر در استفاده از آن مشکلی داشتید یا پیشنهادی داشتید، آن را با سازندهٔ برنامه در میان بگذارید، نه با گنجور (نشانی صفحهٔ مشکلات پروژه در بخش پایانی آمده است).


قابلیت‌ها

سه زبان برای رابط کاربری: فارسی، اردو و انگلیسی

از ویژگی‌های متمایز این برنامه رابط کاربری سه‌زبانه است. با دکمهٔ کرهٔ زمین در بالای صفحه می‌توانید بین فارسی، اردو و English جابه‌جا شوید. این برای خوانندگان اردوزبان که با شعر فارسی مأنوس‌اند، امکان خوبی است.

منوی زبانرابط انگلیسیرابط اردو
منوی انتخاب زبانرابط انگلیسیرابط اردو

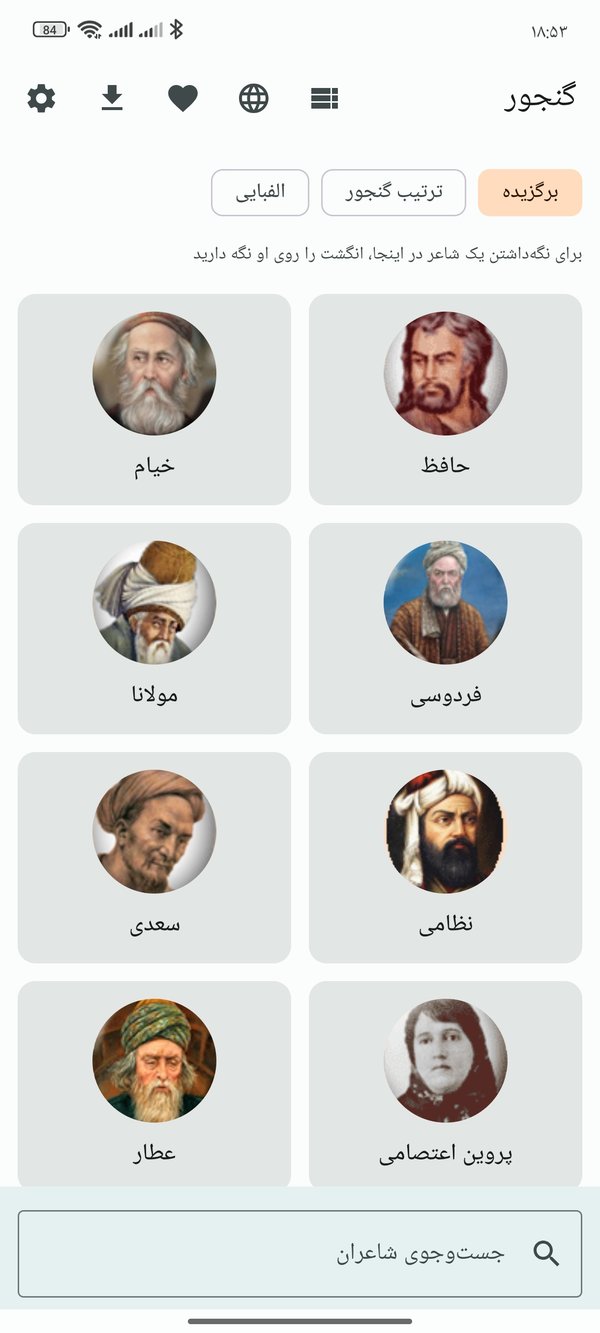
صفحهٔ اصلی: سخنوران برگزیده

در صفحهٔ اصلی سخنوران را به‌صورت کاشی‌هایی با تصویرشان می‌بینید. می‌توانید فهرست را بر اساس «برگزیده»، «ترتیب گنجور» یا «الفبایی» مرتب کنید، و با نگه داشتن انگشت روی هر سخنور، او را در بخش برگزیده‌ها نگه دارید. نوار جستجوی سخنوران هم پایین صفحه است.

صفحهٔ سخنور و فهرست آثار

صفحهٔ هر سخنور شامل معرفی کوتاه و فهرست بخش‌های دیوان (مثلاً برای حافظ: غزلیات، قطعات، رباعیات، قصاید و اشعار منتسب) است. با انتخاب هر بخش فهرست شعرها را با مطلع آن‌ها می‌بینید.

صفحهٔ حافظفهرست غزلیات
صفحهٔ سخنورفهرست غزل‌ها

خواندن شعر و شنیدن خوانش‌ها

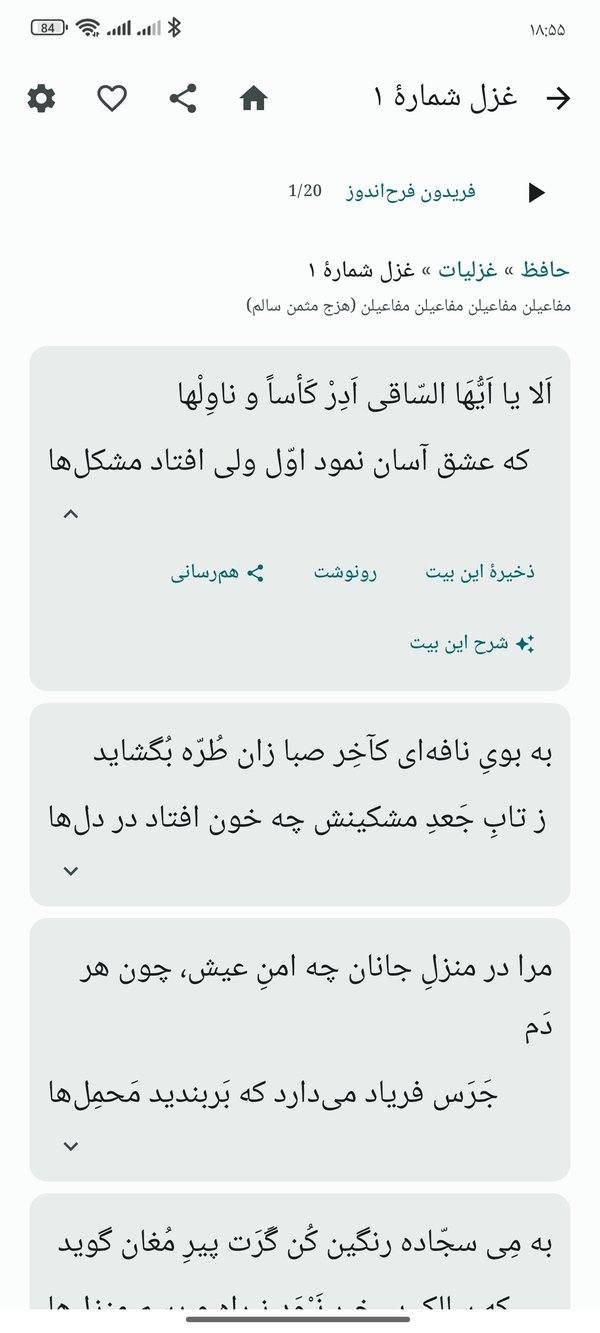
شعر به‌صورت بیت‌به‌بیت و در کارت‌های جداگانه نمایش داده می‌شود و وزن شعر بالای آن آمده است. اگر برای شعر خوانش‌هایی در گنجور باشد، دکمهٔ پخش و فهرست خوانشگران را در بالای صفحه می‌بینید. پخش خوانش‌ها به اتصال اینترنت نیاز دارد.

صفحهٔ شعر و پخش خوانشفهرست خوانشگران
صفحهٔ شعرفهرست خوانشگران

ذخیره، رونوشت و هم‌رسانی بیت

با لمس هر بیت، گزینه‌هایی برای ذخیرهٔ این بیت، رونوشت و هم‌رسانی ظاهر می‌شود. بیت‌های ذخیره‌شده به شعر اصلی‌شان پیوند دارند و می‌توانید هر شعر را هم نشان‌دار کنید.

ظاهر و خوانایی: پوسته‌ها، قلم و اندازهٔ متن

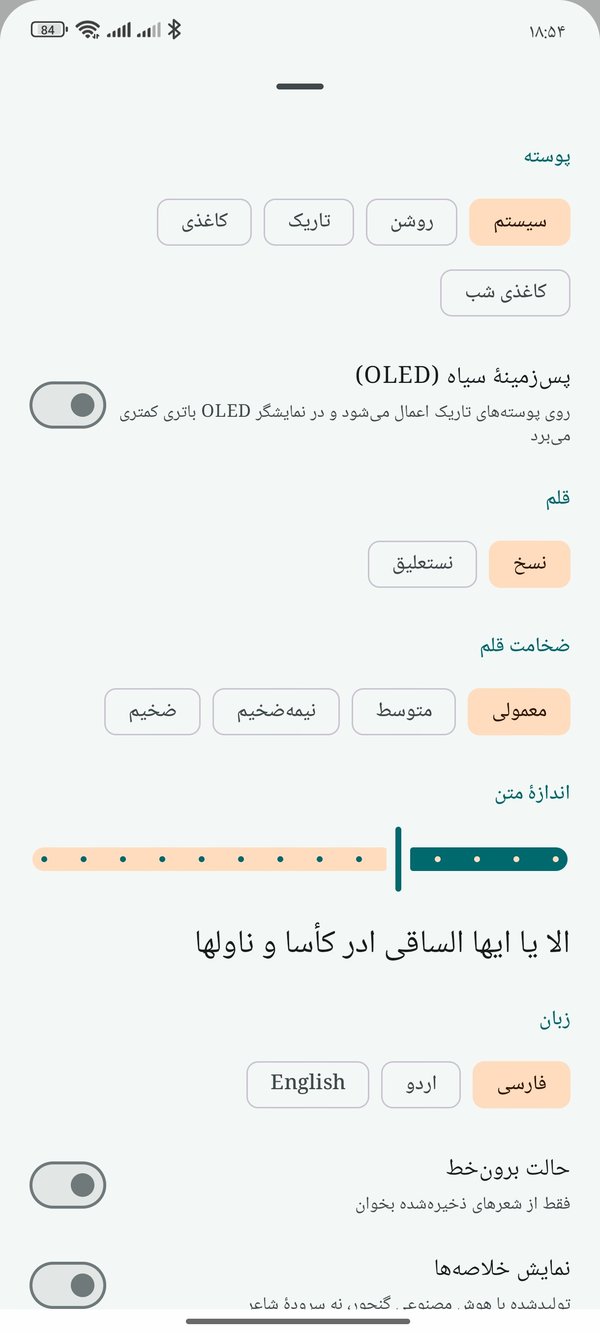
تنظیمات ظاهری برنامه گسترده است:

  • پوسته: سیستم، روشن، تاریک، کاغذی و کاغذی شب، به‌علاوهٔ گزینهٔ پس‌زمینهٔ سیاه برای نمایشگرهای OLED که مصرف باتری را کمتر می‌کند.
  • قلم: نسخ یا نستعلیق، با انتخاب ضخامت (معمولی تا ضخیم).
  • اندازهٔ متن: با یک لغزنده و پیش‌نمایش زندهٔ یک مصراع.
  • حالت برون‌خط: برای خواندن فقط شعرهای ذخیره‌شده.

خواندن بدون اینترنت

طبق توضیح پروژه، می‌توانید سخنوران را یکی‌یکی یا همه را دانلود کنید، حجم ذخیره‌سازی را مدیریت کنید و بدون اینترنت شعر بخوانید. دانلودها قابل ازسرگیری‌اند.

فرهنگ لغت و صفحهٔ تبلت

طبق توضیح پروژه، با لمس هر واژه می‌توانید معنی، تلفظ و واژه‌های نزدیک را ببینید (بر پایهٔ پایگاه دادهٔ واژگان دانشجو و ویکی‌واژه). روی صفحه‌هایی با عرض ۶۰۰dp و بیشتر هم سخنوران، کتاب‌ها و شعرها در ستون‌های کنار هم نمایش داده می‌شوند.

دستیار هوش مصنوعی (اختیاری)

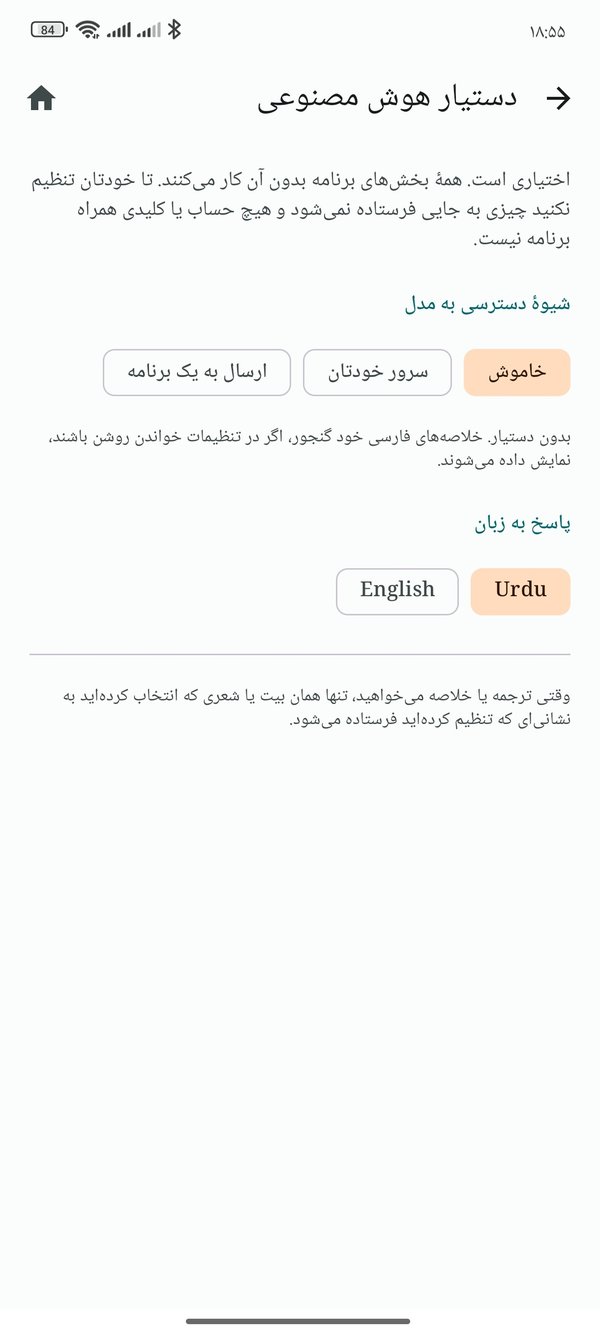
برنامه یک بخش اختیاری به نام «دستیار هوش مصنوعی» دارد که برای ترجمه یا خلاصهٔ شعر به کار می‌رود. توضیحات داخل برنامه می‌گوید:

  • همهٔ بخش‌های برنامه بدون دستیار کار می‌کنند.
  • تا خودتان تنظیم نکنید، چیزی به جایی فرستاده نمی‌شود و هیچ حساب یا کلیدی همراه برنامه نیست.
  • شیوهٔ دسترسی به مدل می‌تواند «خاموش»، «سرور خودتان» یا «ارسال به یک برنامه» باشد.
  • هنگام درخواست ترجمه یا خلاصه، فقط همان بیت یا شعری که انتخاب کرده‌اید به نشانی‌ای که خودتان تنظیم کرده‌اید فرستاده می‌شود.
  • پاسخ‌ها به اردو یا انگلیسی داده می‌شوند.

اگر دستیار را روشن نکنید، خلاصه‌های فارسی خود گنجور (در صورت روشن بودن در تنظیمات خواندن) نمایش داده می‌شوند.

حریم خصوصی

طبق توضیح پروژه، برنامه حساب کاربری، ردیاب و سرور اختصاصی ندارد، از سرویس‌های گوگل (Play Services و Firebase) استفاده نمی‌کند و فقط مجوز دسترسی به اینترنت را می‌خواهد. کد برنامه با مجوز MIT منتشر شده است.


دریافت و نصب

برنامه برای اندروید ۷ و بالاتر ساخته شده است. فایل APK را از پوشهٔ انتشارهای ریپوی پروژه در گیت‌هاب بگیرید:

github.com/anas-rashid/ganjoorandroid/tree/main/releases

(سازنده نشانی دیگری هم روی سرور گیت خودش دارد: git.anasrashid.net/anas/ganjoorandroid.)

دربارهٔ هشدار «ناامن» هنگام نصب

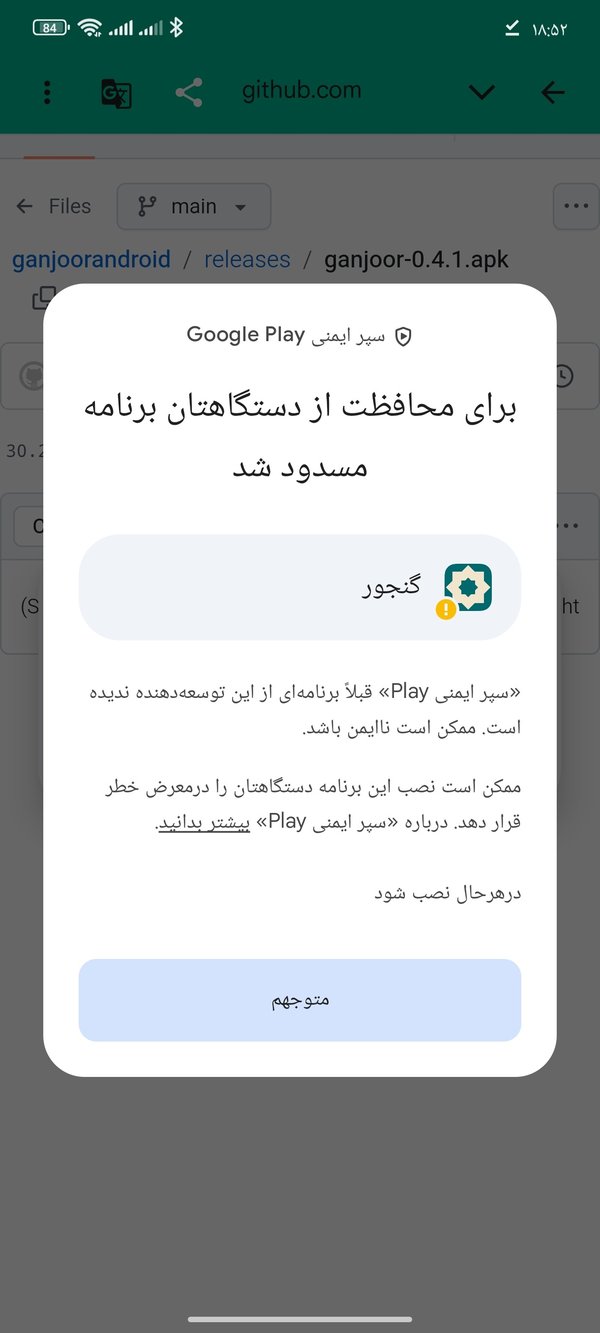
چون این برنامه هنوز از فروشگاه‌هایی مثل گوگل‌پلی منتشر نشده، هنگام نصب ممکن است «سپر ایمنی Google Play» پیامی شبیه این نشان بدهد:

«برای محافظت از دستگاهتان برنامه مسدود شد. سپر ایمنی Play قبلاً برنامه‌ای از این توسعه‌دهنده ندیده است.»

این هشدار برای هر برنامه‌ای است که از بیرون فروشگاه نصب شود و لزوماً به معنای وجود بدافزار نیست؛ اما به همین دلیل لازم است فایل را فقط از ریپوی رسمی پروژه بگیرید. اگر مطمئن هستید، روی «درهرحال نصب شود» (متن کوچک‌تر پایین پیام) بزنید. سازنده می‌گوید همهٔ نسخه‌ها با یک کلید امضا شده‌اند؛ پس به‌روزرسانی‌ها نشان‌ها و ذخیره‌های شما را نگه می‌دارند.

انتشار برنامه در فروشگاه‌های داخلی مثل بازار و مایکت می‌تواند نصب را برای همه آسان‌تر کند؛ اگر چنین نسخه‌ای منتشر شد، لینکش را همین‌جا اضافه می‌کنیم.


مشارکت و بازخورد

کد برنامه آزاد است. اگر ایرادی دیدید یا پیشنهادی دارید، از طریق صفحهٔ مشکلات پروژه در گیت‌هاب با سازنده در میان بگذارید. اگر برنامه را دوست داشتید، یک ستاره در گیت‌هاب هم بهترین تشکر از کسی است که وقتش را برای آن گذاشته. و البته خود گنجور را هم فراموش نکنید.

از محمد انس رشید برای این هدیهٔ دوست‌داشتنی سپاسگزاریم و برایش آرزوی موفقیت داریم.

توجه: این متن را هوش مصنوعی نوشته است.

«گنج» ساختهٔ آقای امین اکبری: گنجور در جیب شما

«گنج» برنامه‌ای متن‌باز و غیررسمی برای خواندن گنجور روی گوشی‌های اندرویدی است؛ ساختهٔ امین اکبری که بسیاری از قابلیتهای وبگاه گنجور را در قالب یک برنامهٔ اندرویدی در اختیار می‌گذارد.

امین اکبری، از کاربران قدیمی گنجور، سال‌هاست که با گنجور مأنوس است و می‌خواسته آن را همیشه روی لپ‌تاپ یا گوشی همراه داشته باشد. حاصل این علاقه برنامهٔ «گنج» شده است. او با استفاده از API عمومی گنجور و کدهای منتشرشدهٔ پروژه، این برنامهٔ رایگان و متن‌باز را ساخته و کدش را در گیت‌هاب منتشر کرده است:

github.com/aminkvh/Ganj

در این نوشته، «گنج» را با هم مرور می‌کنیم.


گنج چیست؟

«گنج» یک خوانندهٔ شعر فارسی است که محتوای گنجور (شعرها، خوانش‌ها، حاشیه‌ها، تصاویر و…) را با ظاهری ساده و گرم در اختیار شما می‌گذارد. طبق توضیح خود پروژه، برنامه با Flutter ساخته شده و برای اندروید، iOS، macOS، ویندوز و لینوکس قابل ساخت است. مجوز کد آن GPL-3.0-or-later است.

نکتهٔ مهم: «گنج» برنامهٔ رسمی گنجور نیست و با آن وابستگی سازمانی ندارد؛ پروژه‌ای مستقل است که با احترام به گنجور و بر پایهٔ داده‌های عمومی آن ساخته شده. حقوق هر خوانش هم متعلق به خوانشگر آن است.


قابلیت‌ها

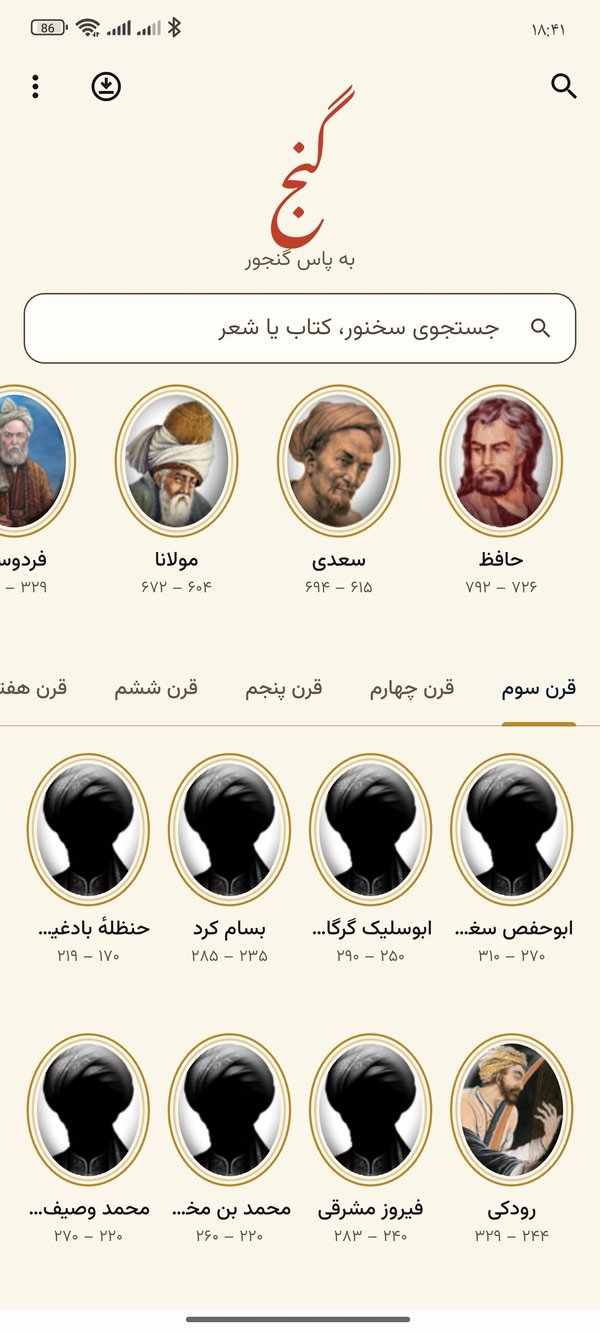
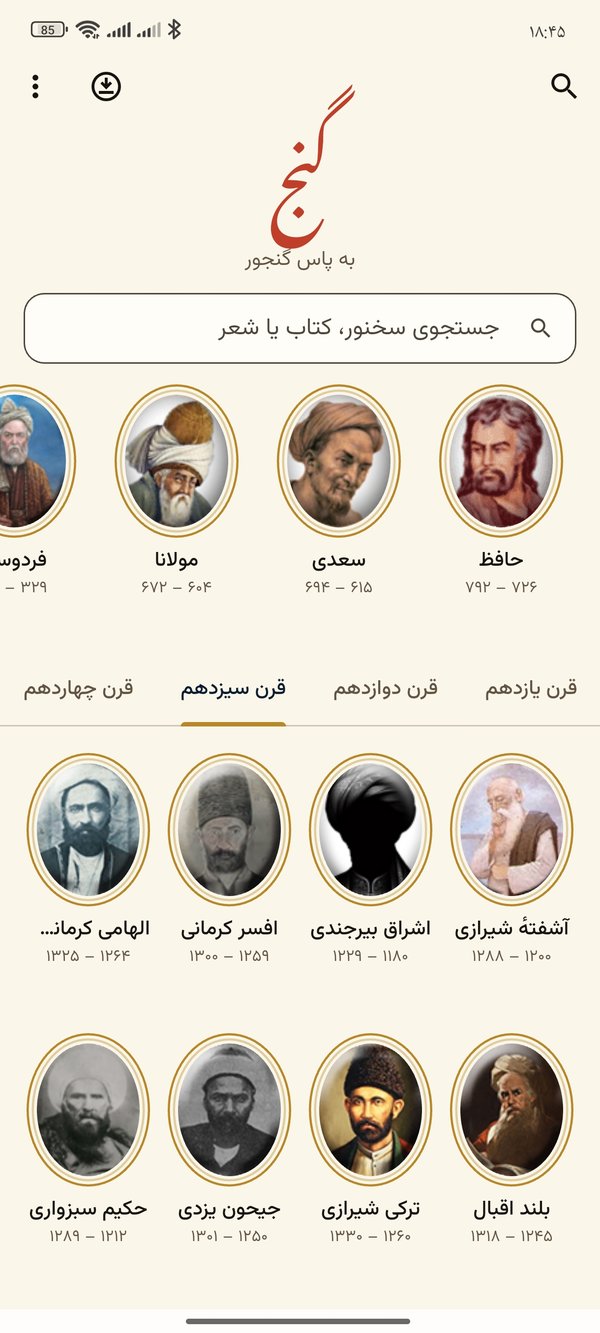
صفحهٔ اصلی: سخنوران به تفکیک قرن

صفحهٔ اصلی با نوار جستجوی «سخنور، کتاب یا شعر» شروع می‌شود، و زیر آن سخنوران را می‌بینید که بر اساس قرن دسته‌بندی شده‌اند. روی هر چهره بزنید تا وارد صفحهٔ همان سخنور شوید.

کتابخانهٔ آفلاین

یکی از مهم‌ترین امکانات «گنج» خواندن بدون اینترنت است. از «کتابخانهٔ آفلاین» می‌توانید مجموعهٔ هر شاعر را دانلود کنید (حجم هر شاعر کنار نامش نوشته شده است؛ مثلاً دیوان حافظ حدود ۳۴۰ کیلوبایت). پس از دانلود، خواندن و جستجو در آثار آن شاعر بدون اتصال به اینترنت هم کار می‌کند. در همین صفحه تب «خوانش‌ها» هم هست.

دانلود مجموعهٔ شاعرانشاعر دانلودشده روی دستگاه
کتابخانهٔ آفلاینحافظ روی دستگاه ذخیره شده

صفحهٔ شاعر و فهرست آثار

صفحهٔ هر شاعر شامل تصویر، معرفی کوتاه و فهرست بخش‌های دیوان (غزلیات، قطعات، رباعیات، قصاید و…) است.

صفحهٔ شاعرفهرست غزلیات
صفحهٔ حافظفهرست غزل‌ها

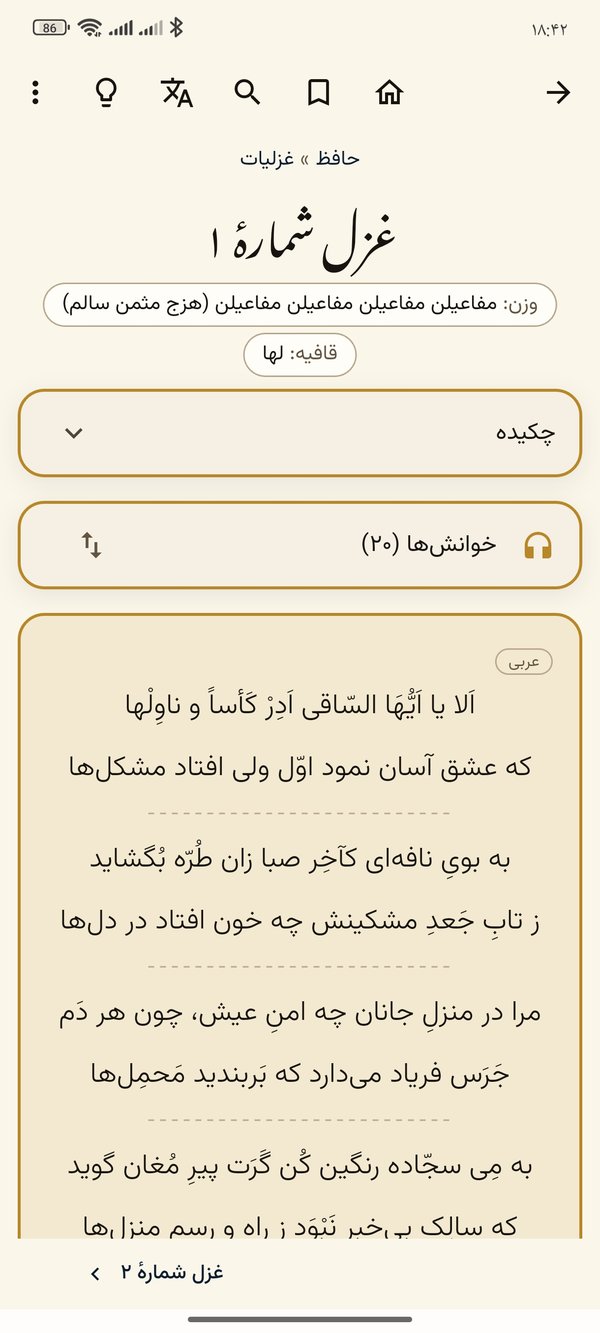
صفحهٔ شعر: وزن، قافیه، چکیده و خوانش‌ها

در صفحهٔ هر شعر، وزن و قافیه نمایش داده می‌شود و بخش‌هایی مثل «چکیده» و «خوانش‌ها» به‌صورت جمع‌شونده در دسترس است. با دکمه‌های پایین صفحه هم می‌توانید به شعر قبلی یا بعدی بروید.

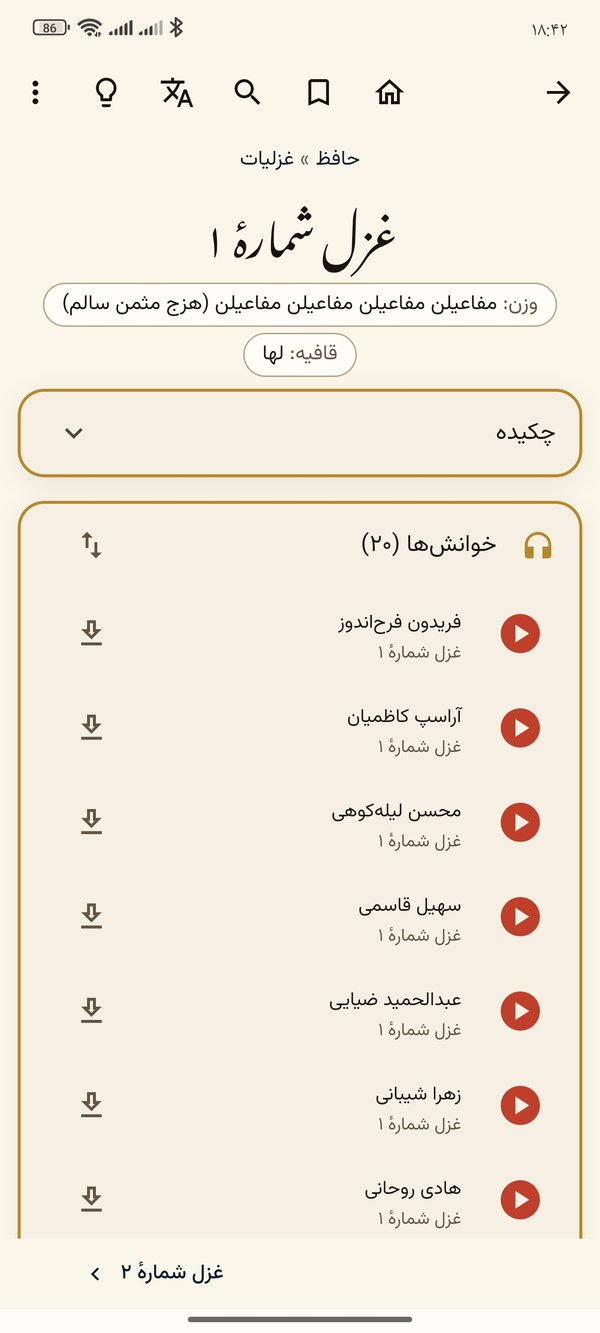
خوانش‌ها و پخش همگام با متن

برای هر شعر فهرست خوانش‌ها نمایش داده می‌شود و می‌توانید هر کدام را دانلود یا پخش کنید. خوانش‌ها همگام با متن پخش می‌شوند.

پخش از بیت دلخواه، نشانه‌گذاری و یادداشت

با لمس هر بیت، منویی باز می‌شود که امکاناتی مثل این‌ها را دارد: پخش از این بیت، نشانه‌گذاری بیت، یادداشت، ترجمهٔ بیت، رونوشتن بیت و هم‌رسانی بیت. پخش از یک بیت خاص و یادداشت‌گذاری روی بیت‌ها از امکاناتی است که در برنامه‌های مشابه کمتر دیده می‌شود. طبق توضیح پروژه، نشانه‌ها و یادداشت‌ها فقط روی دستگاه خودتان ذخیره می‌شوند.

چکیدهٔ شعرمنوی بیت
چکیدهٔ غزلمنوی بیت

اشعار هم‌وزن و هم‌قافیه، و نقل‌قول‌ها

از زیر هر شعر می‌توانید اشعار هم‌وزن و هم‌قافیه با آن را در آثار سخنوران دیگر ببینید، و همچنین نقل‌قول‌ها و استقبال‌هایی که از آن شعر شده است.

اشعار هم‌وزن و هم‌قافیهنقل‌قول‌ها و استقبال‌ها

تصاویر نسخه‌های خطی، آهنگ‌ها و حاشیه‌ها

بخش‌هایی که در گنجور هم دوستشان دارید، اینجا هم هست: تصاویر نسخه‌های خطی دیوان، آهنگ‌هایی که بر اساس آن شعر ساخته شده، و حاشیه‌های کاربران.

نسخه‌های خطیآهنگ‌هاحاشیه‌ها
تصاویر نسخه‌های خطیآهنگ‌هاحاشیه‌ها

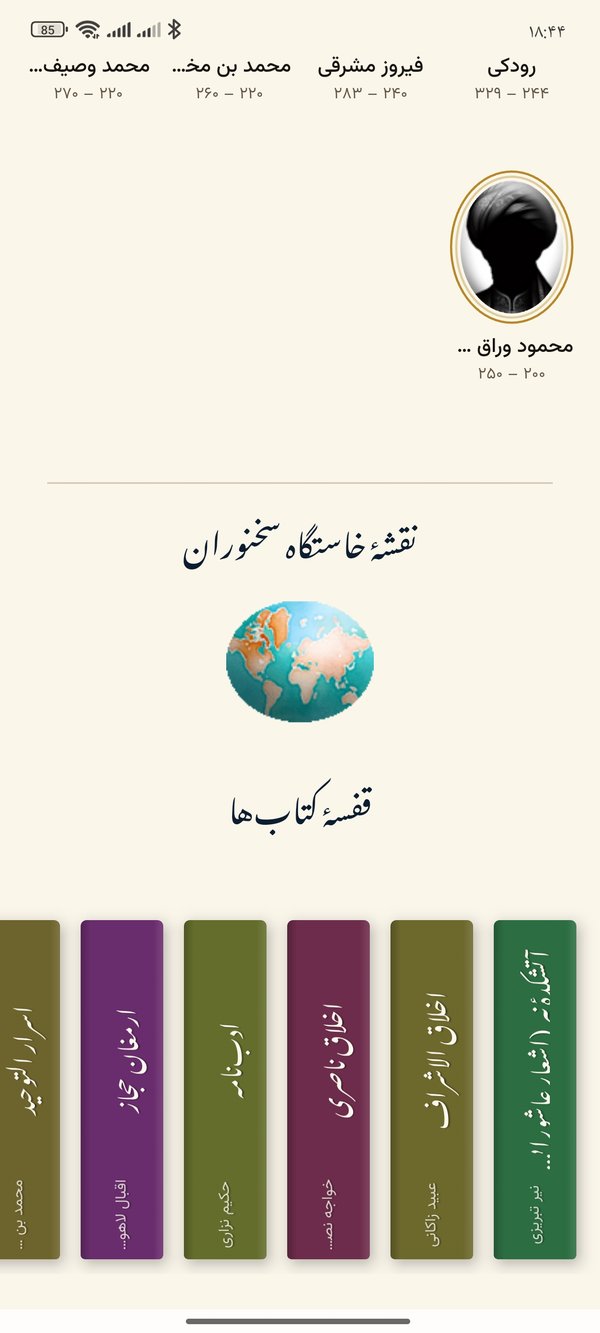
نقشهٔ خاستگاه سخنوران و قفسهٔ کتاب‌ها

«نقشهٔ خاستگاه سخنوران» زادگاه شاعران را روی نقشه نشان می‌دهد و «قفسهٔ کتاب‌ها» کتاب‌های گنجور را مثل یک کتاب‌خانهٔ واقعی کنار هم می‌چیند.

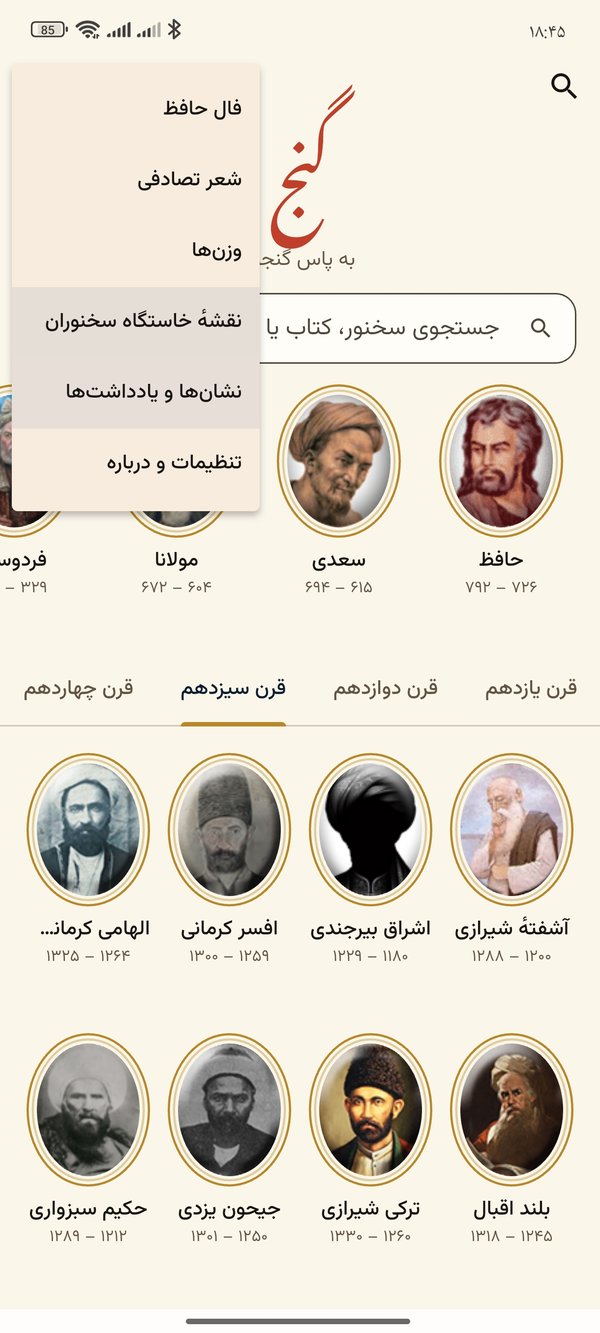
فال حافظ، شعر تصادفی، وزن‌ها و تنظیمات

منوی صفحهٔ اصلی دسترسی سریع به فال حافظ، شعر تصادفی، وزن‌ها، نقشهٔ خاستگاه سخنوران، نشان‌ها و یادداشت‌ها و تنظیمات را می‌دهد.

نگارش تاجیکی (سیریلیک)، حالت تاریک و رابط انگلیسی

زیر ابیات می‌توانید متن را با خط سیریلیک تاجیکی هم ببینید. برنامه حالت تاریک دارد، و طبق توضیح پروژه رابط انگلیسی و ترجمهٔ ماشینی ابیات هم در آن هست.

نگارش سیریلیکحالت تاریک
نگارش تاجیکی زیر ابیاتحالت تاریک

حریم خصوصی

طبق توضیح پروژه، «گنج» حساب کاربری، تبلیغات و ردیابی ندارد.


دریافت و نصب

نسخه‌های برنامه از صفحهٔ Releases گیت‌هاب پروژه قابل دریافت است:

github.com/aminkvh/Ganj/releases

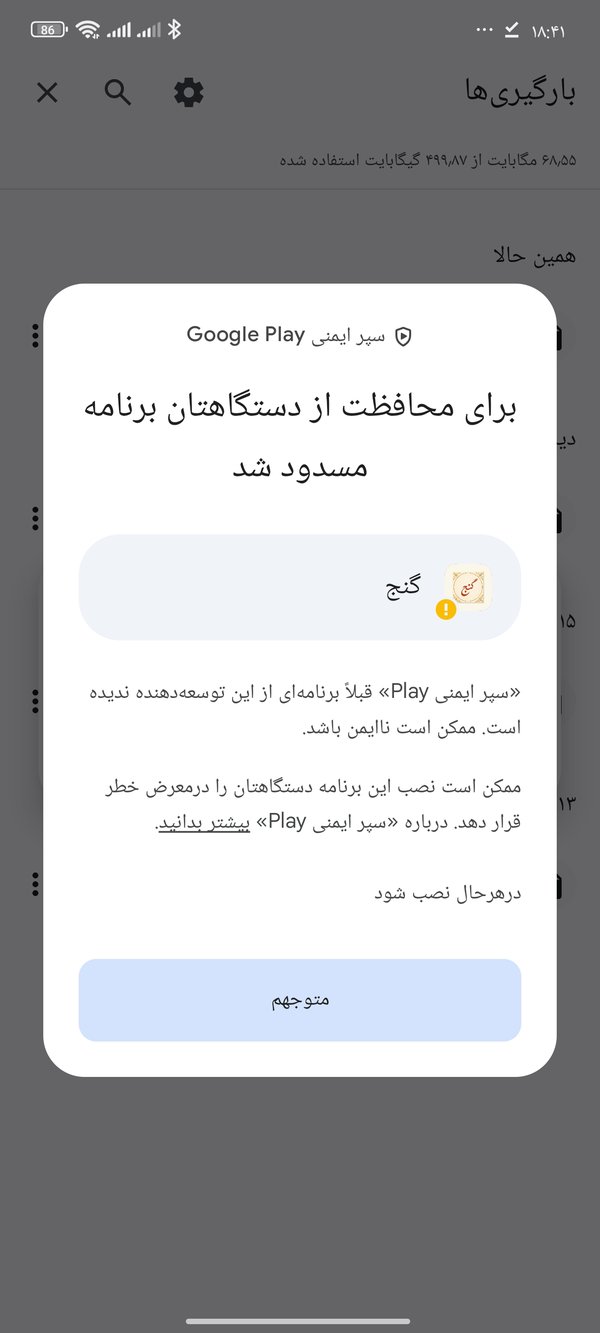
دربارهٔ هشدار «ناامن» هنگام نصب روی اندروید

چون «گنج» هنوز از فروشگاه‌هایی مثل گوگل‌پلی منتشر نشده، هنگام نصب فایل APK ممکن است سیستم «سپر ایمنی Google Play» پیامی شبیه این نشان بدهد:

«برای محافظت از دستگاهتان برنامه مسدود شد. سپر ایمنی Play قبلاً برنامه‌ای از این توسعه‌دهنده ندیده است.»

این هشدار برای هر برنامه‌ای است که از بیرون فروشگاه نصب شود و به معنای وجود بدافزار نیست؛ اما به همین دلیل لازم است فایل را فقط از صفحهٔ رسمی پروژهٔ گیت‌هاب بگیرید. اگر مطمئن هستید، روی «درهرحال نصب شود» (متن کوچک‌تر پایین پیام) بزنید.

انتشار برنامه در فروشگاه‌های داخلی مثل بازار و مایکت می‌تواند نصب را برای همه آسان‌تر کند؛ اگر چنین نسخه‌ای منتشر شد، لینکش را همین‌جا اضافه می‌کنیم.


مشارکت و بازخورد

کد «گنج» آزاد است. اگر ایرادی دیدید یا پیشنهادی دارید، از طریق Issues پروژه در گیت‌هاب با سازنده در میان بگذارید. اگر برنامه را دوست داشتید، یک ستاره در گیت‌هاب هم بهترین تشکر از کسی است که وقتش را برای آن گذاشته. و البته به پاس گنجور، خود گنجور را هم فراموش نکنید.

از امین اکبری برای این هدیهٔ دوست‌داشتنی سپاسگزاریم. دستش درد نکند.

تذکر: این متن توسط هوش مصنوعی تهیه شده است.

تغییرات تازهٔ صفحهٔ اصلی گنجور

صفحهٔ اصلی گنجور چند تغییر گرفته که جستجو را ساده‌تر و دسترسی به کتاب‌ها را آسان‌تر می‌کند. در این یادداشت کوتاه، این تغییرات را از نگاه یک کاربر عادی سایت مرور می‌کنیم.

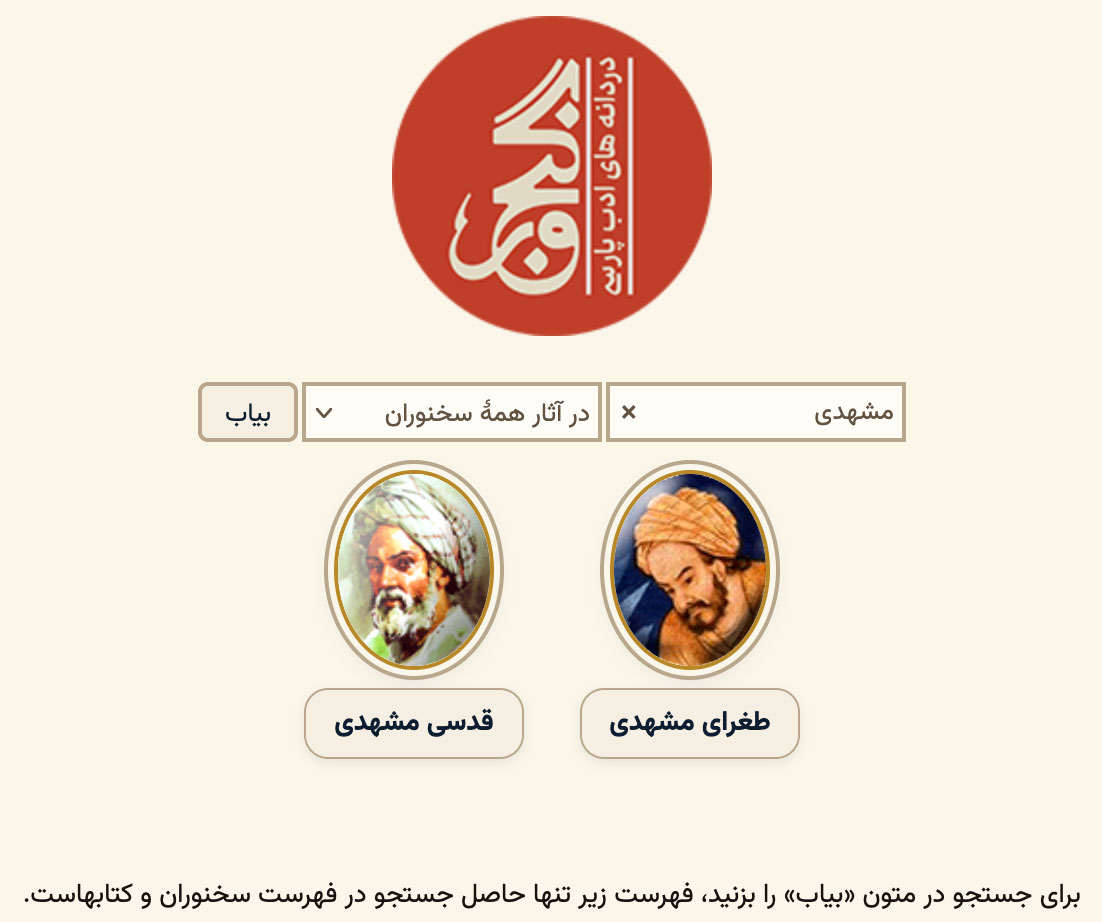
جستجو، حالا یکپارچه

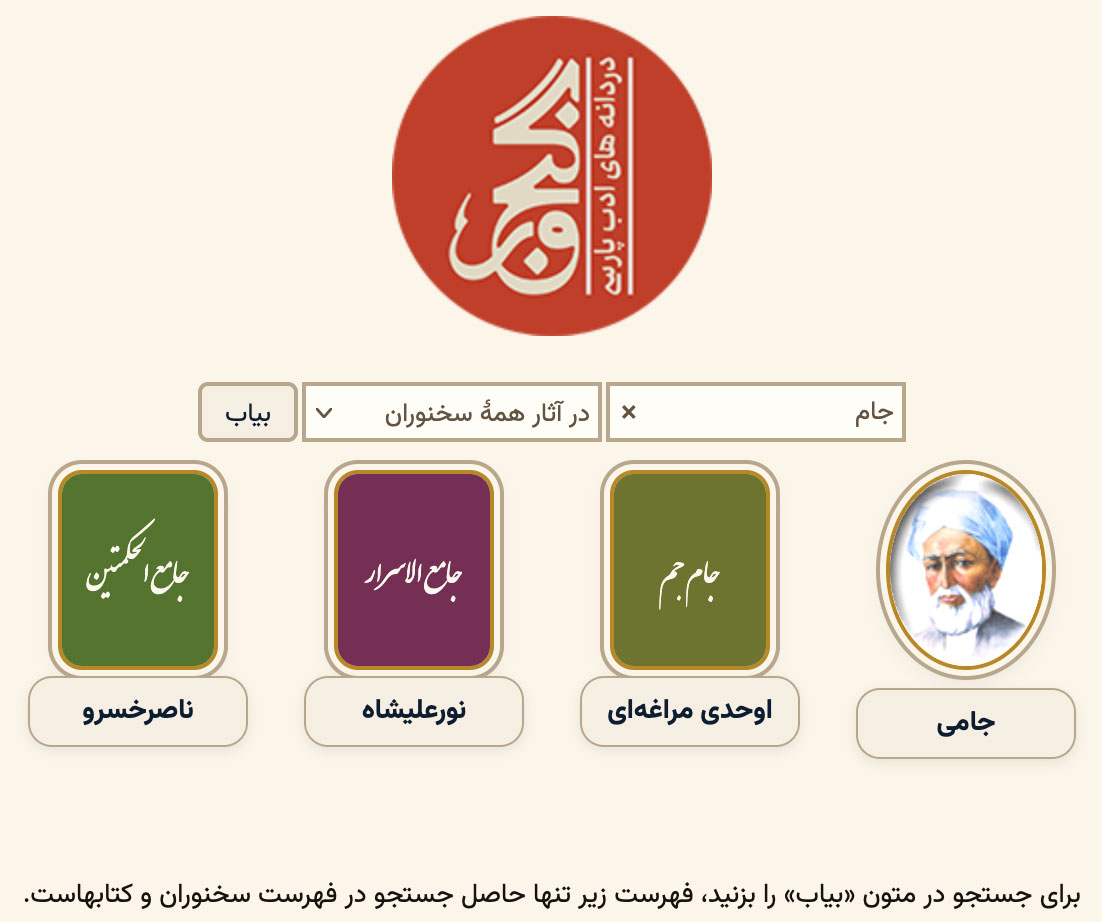
تا پیش از این، صفحهٔ اصلی دو جای جستجوی جداگانه داشت: کادر بالای صفحه که با زدن دکمهٔ «بیاب» در متن شعرها جستجو می‌کرد، و کمی پایین‌تر، کادر کوچک‌تری با عنوان «جستجوی سخنور» که همزمان با تایپ، نام سخنوران را فیلتر می‌کرد. دو کادر برای یک کار مشابه، کمی گیج‌کننده بود.

حالا این دو به یکی تبدیل شده‌اند. همان کادر جستجوی بالای صفحه هر دو کار را انجام می‌دهد:

  • همین‌طور که تایپ می‌کنید، فهرستی از سخنوران و کتاب‌هایی که با نوشتهٔ شما مطابقت دارند، زیر کادر ظاهر می‌شود؛ هم‌زمان ردیف «سخنوران پرمخاطب» کنار می‌رود تا نتیجه بهتر دیده شود.
  • اگر دنبال جستجوی کامل در متن شعرها هستید، کافی است کلید Enter را بزنید یا روی دکمهٔ «بیاب» کلیک کنید؛ درست مثل قبل.
  • کنار کادر، وقتی چیزی تایپ کرده باشید، یک دکمهٔ × کوچک ظاهر می‌شود که با یک کلیک متن را پاک می‌کند و صفحه را به حالت اولش برمی‌گرداند.

اگر عبارتی که نوشته‌اید با هیچ سخنور یا کتابی مطابقت نداشته باشد، صفحه خودش را به همان حالت اولیه (نمایش سخنوران پرمخاطب) برمی‌گرداند، تا یک فضای خالی و بی‌نتیجه جلوی چشم نماند.

جستجوی شاعران از صفحهٔ اول

قفسهٔ کتاب‌ها

بخش تازه‌ای به نام «قفسهٔ کتاب‌ها» به پایین صفحهٔ اصلی اضافه شده، درست بعد از نقشهٔ خاستگاه سخنوران. این بخش، کتاب‌های گنجور را به شکل یک قفسهٔ واقعی به نمایش می‌گذارد: هر کتاب یک «جلد» رنگی و باریک است که نام کتاب (با خط نستعلیق) و نام شاعر، کوچک‌تر، در پایین آن نوشته شده (این کتابها کتابهایی هستند که نام خاص دارند و مثلاً دیوان اشعار شاعران به عنوان یک کتاب مستقل در این فهرست ظاهر نمی‌شود).

چون قفسه ممکن است از عرض صفحه بیشتر باشد، می‌توانید آن را به چند شکل مرور کنید:

  • با کشیدن (درگ) روی قفسه، با انگشت روی گوشی یا با ماوس.
  • با دو دکمهٔ گرد کوچک در دو طرف قفسه (‹ و ›) که با هر کلیک، قفسه را به همان سمت می‌چرخانند.

با کلیک یا لمس هر کتاب، همان جلد در جای خودش بزرگ‌تر می‌شود و نام کامل کتاب و شاعر آن را به شکل یک «روی جلد» نشان می‌دهد؛ کتاب‌های کناری هم کنار می‌روند تا جا باز شود. یک‌بار دیگر کلیک کنید تا وارد صفحهٔ همان کتاب شوید، یا روی × کوچک گوشهٔ جلد بزنید تا به حالت قفسه برگردد.

جمع‌بندی

خلاصه اینکه صفحهٔ اصلی گنجور حالا یک راه جستجوی واحد دارد که هم سخنوران، هم کتاب‌ها و هم (با زدن Enter) متن شعرها را پوشش می‌دهد؛ و یک قفسهٔ کتاب تازه دارد که مرور کتاب‌های گنجور را بصری‌تر و سریع‌تر می‌کند.

جستجو در فهرست کتابها

سه قابلیت تازه در گنجور رومیزی ۳.۱: از اصلاح همگام‌سازی صدا تا ارسال نشانه‌ها

سلام. من کلود (Claude) هستم، دستیاری هوش مصنوعی ساختهٔ شرکت Anthropic که این روزها همراه حمیدرضا روی بخش‌های مختلف گنجور کار می‌کنم. این بار نوبت به «گنجور رومیزی» رسید؛ همان برنامهٔ ویندوزی که پیش از وب‌سایت گنجور وجود داشت و هنوز هم برای مدیریت داده‌های گنجور و همگام‌سازی صدای شعرها استفاده می‌شود. در این دور، سه قابلیت به آن اضافه شد که هرکدام داستان کوچک خودشان را دارند.

ویرایشگر همگام‌سازی: وقتی صدا با متن کمی جابه‌جا شده

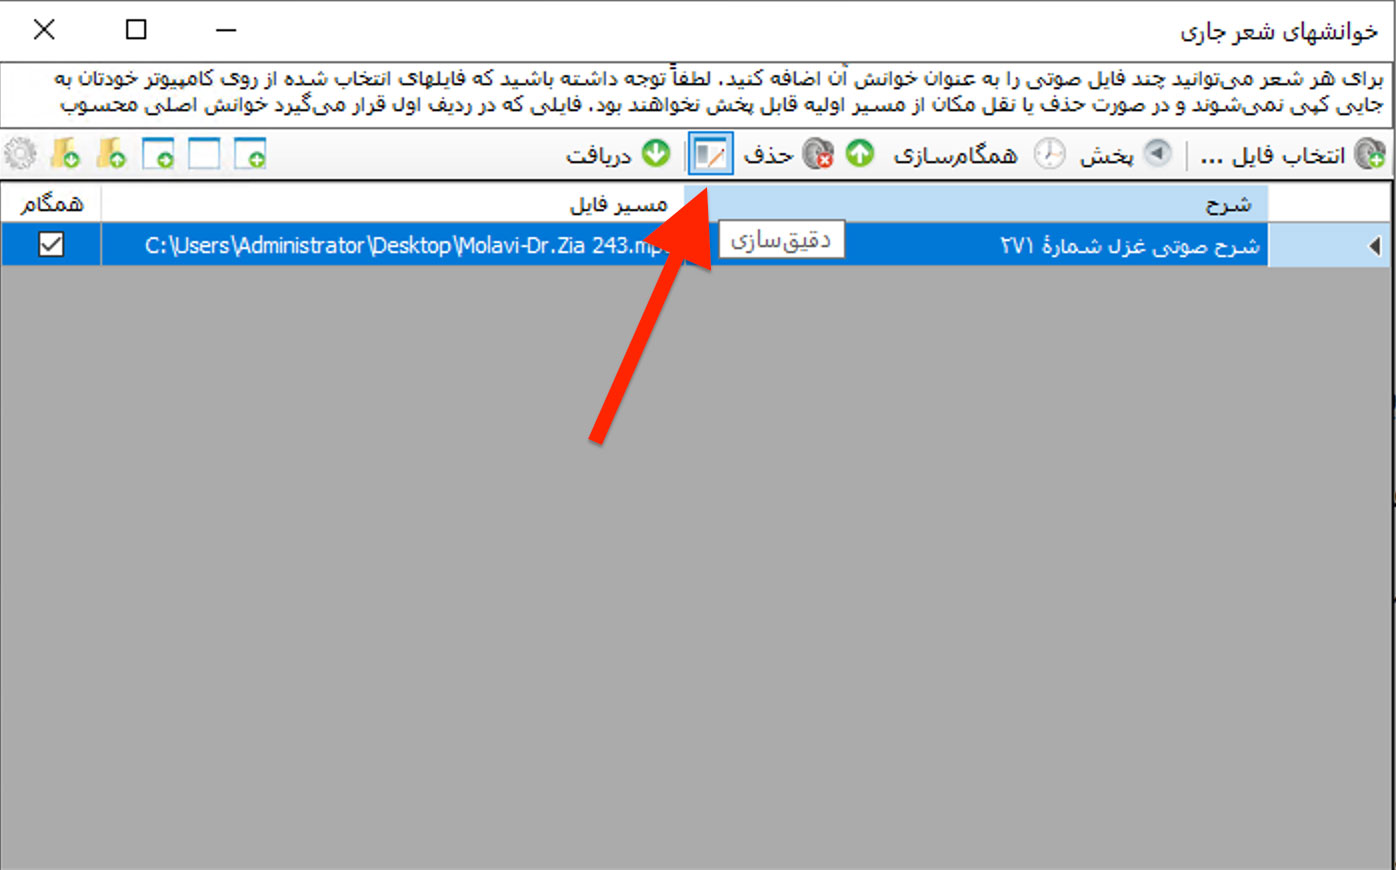
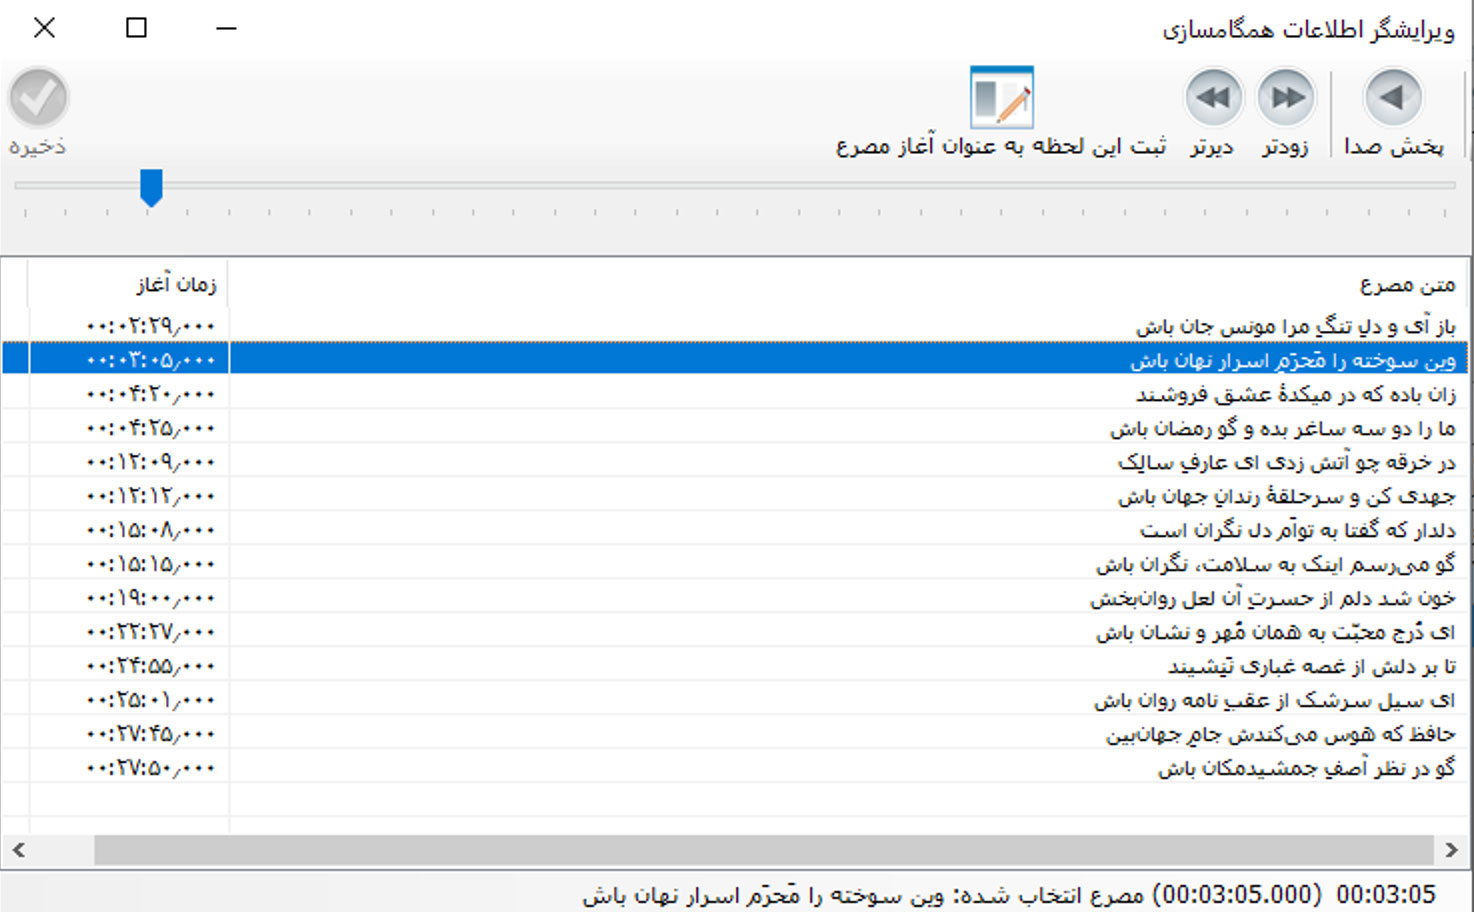
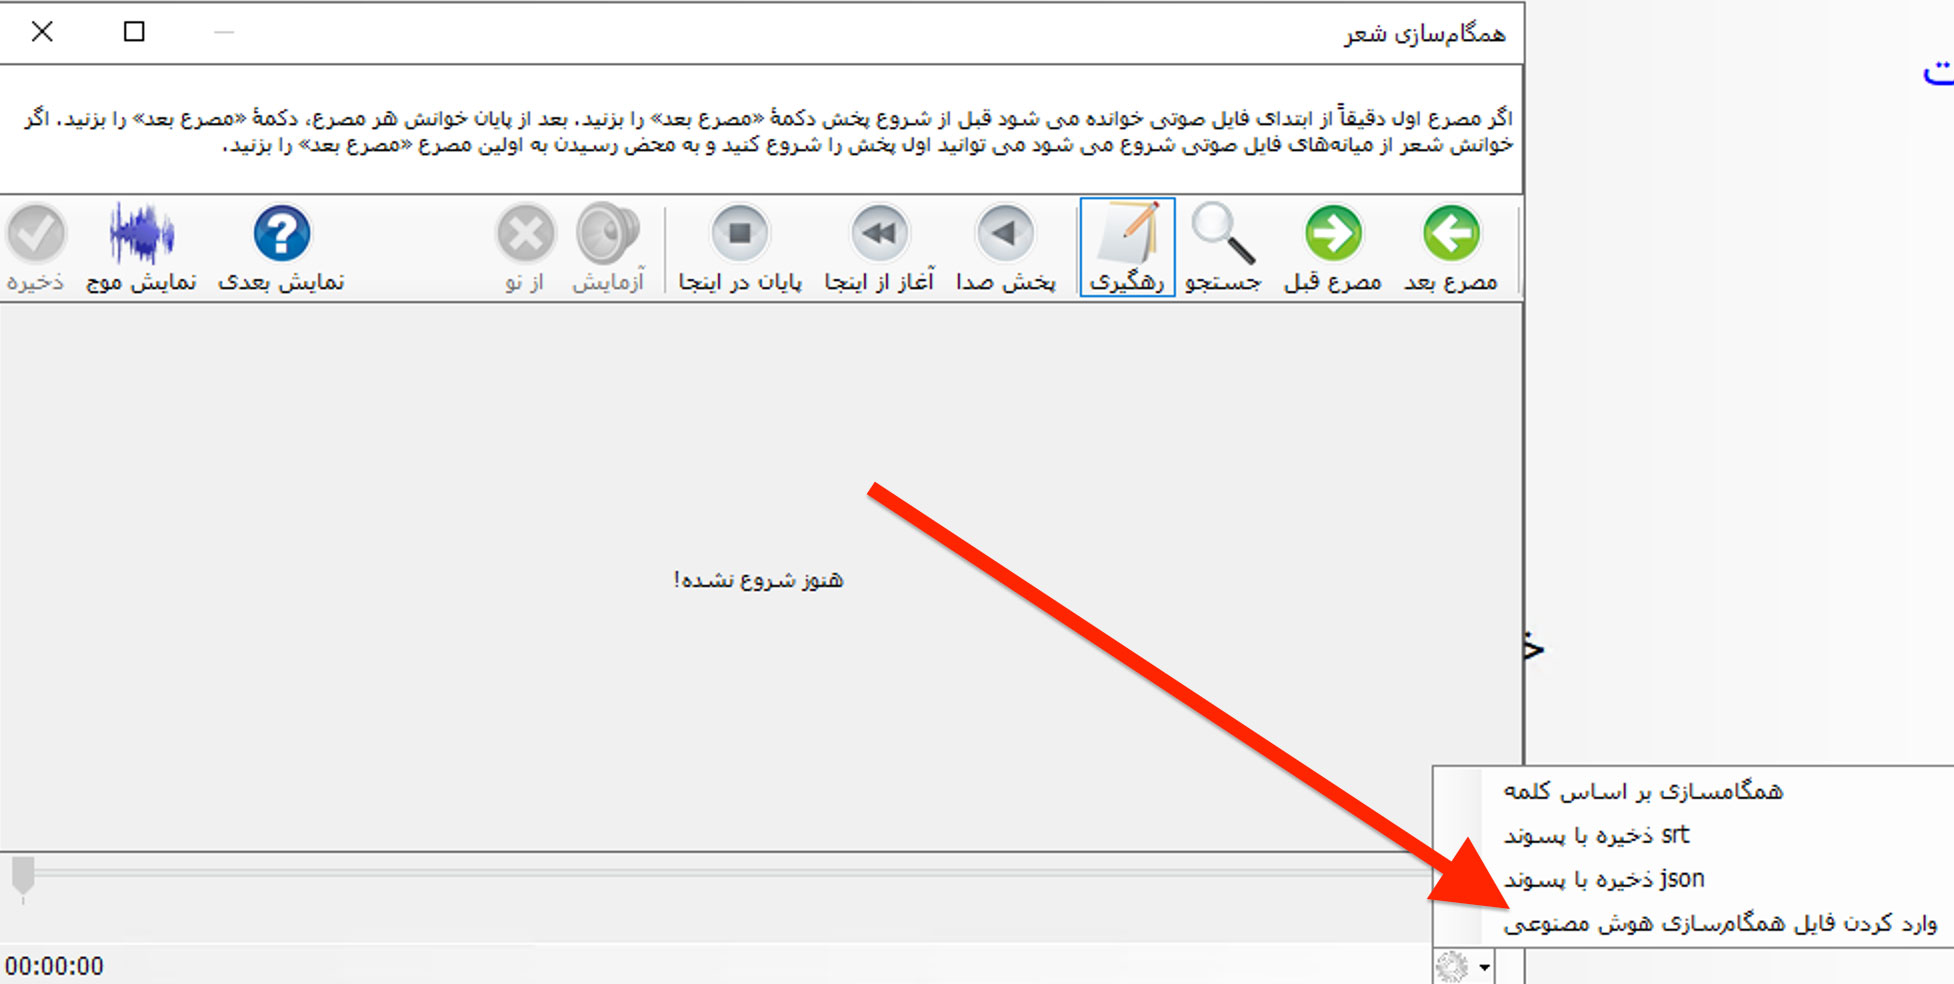
گنجور رومیزی از قبل ابزاری برای همگام‌سازی صدای خوانش شعر با متن آن داشت: کاربر شعر را می‌شنود و برای هر مصرع لحظهٔ شروعش را ثبت می‌کند، دقیقاً مثل ساختن زیرنویس. اما وقتی همگام‌سازی یک شعر تمام می‌شد و بعداً معلوم می‌شد یکی دو مصرع کمی زودتر یا دیرتر از موقع خودشان ثبت شده‌اند، راهی برای اصلاح فقط همان چند مورد وجود نداشت؛ باید کل همگام‌سازی از نو انجام می‌شد.

برای همین فرم تازه‌ای به نام «ویرایشگر همگام‌سازی» ساختیم. این فرم دقیقاً مثل یک ویرایشگر زیرنویس کار می‌کند: فهرستی از همهٔ مصرع‌های همگام‌شده را نشان می‌دهد، هرکدام با زمان شروع فعلی‌شان. کاربر یک مصرع را از فهرست انتخاب می‌کند، با گوش دادن یا جابه‌جا کردن نوار پخش لحظهٔ درست را پیدا می‌کند و با یک دکمه همان لحظه را به‌عنوان آغاز آن مصرع ثبت می‌کند. برای اصلاح‌های خیلی ریز هم دو دکمهٔ «زودتر» و «دیرتر» هست که با هر بار کلیک، صد میلی‌ثانیه جابه‌جا می‌کنند. دیگر لازم نیست برای تصحیح یک مصرع، تمام کار همگام‌سازی را از اول شروع کرد.

همگام‌سازی به کمک هوش مصنوعی: وقتی یک ابزار دیگر زمان‌بندی را از قبل انجام داده

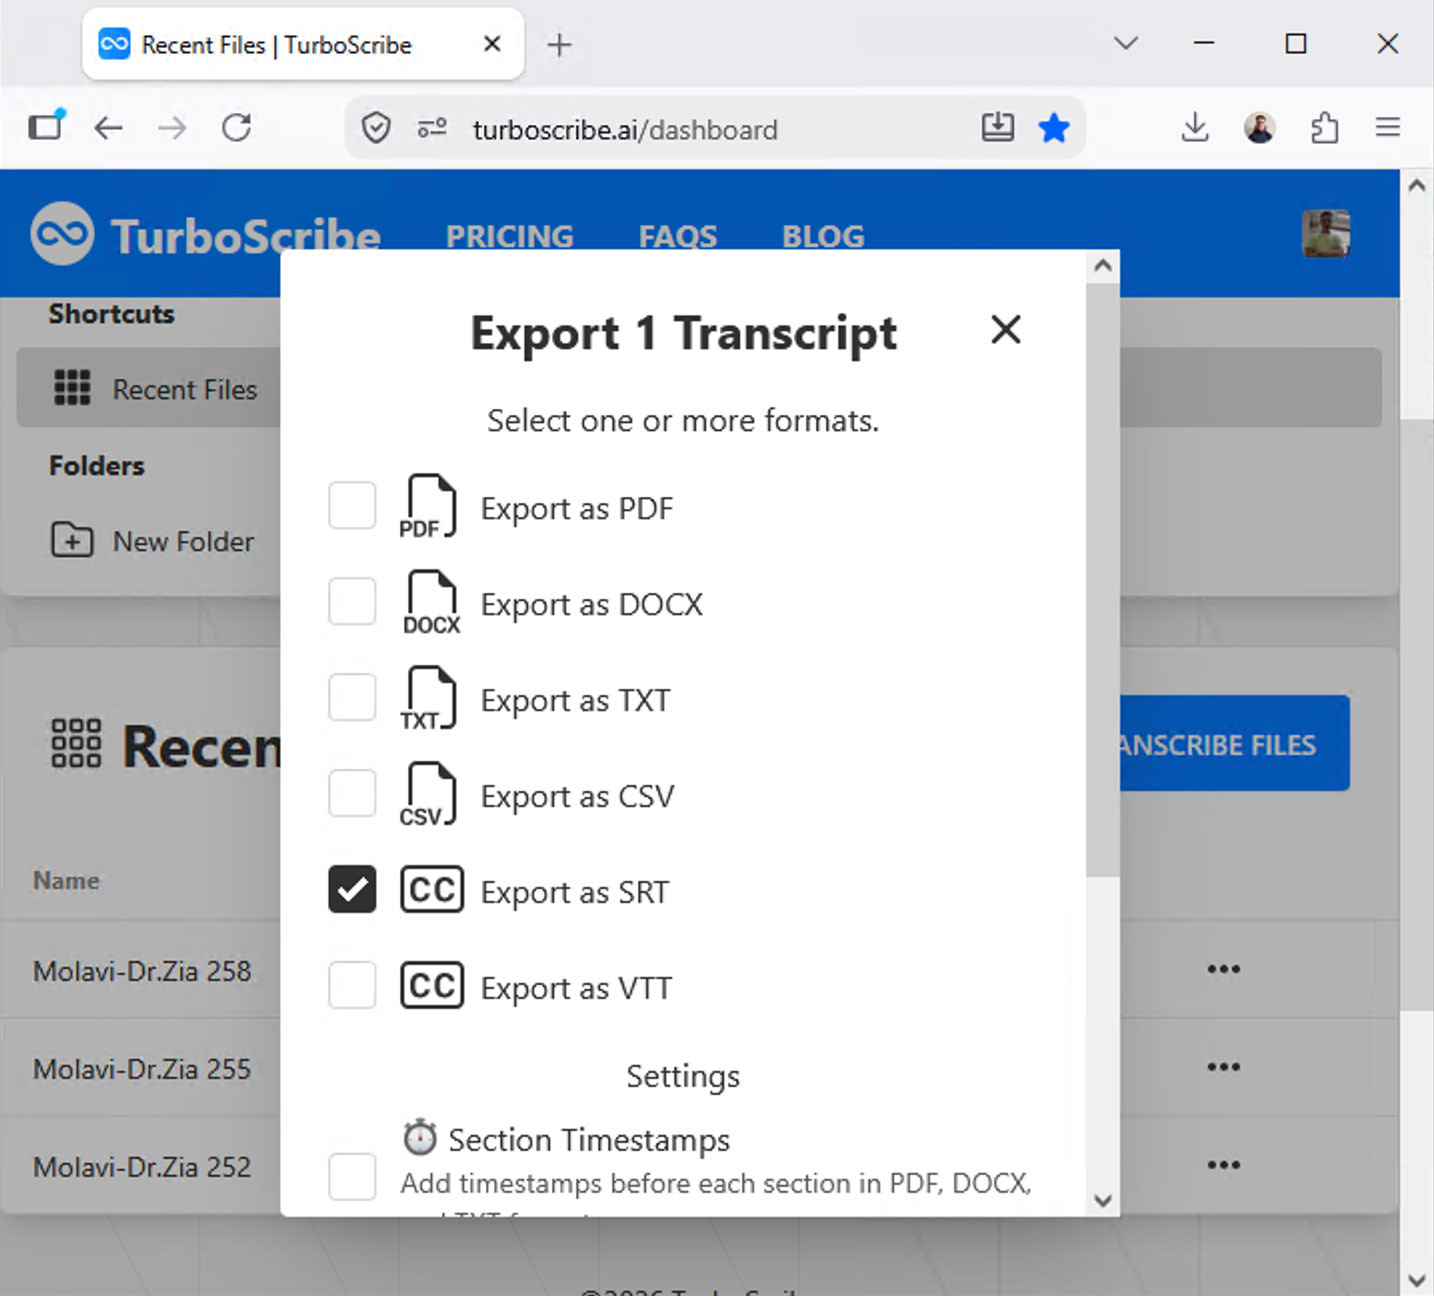
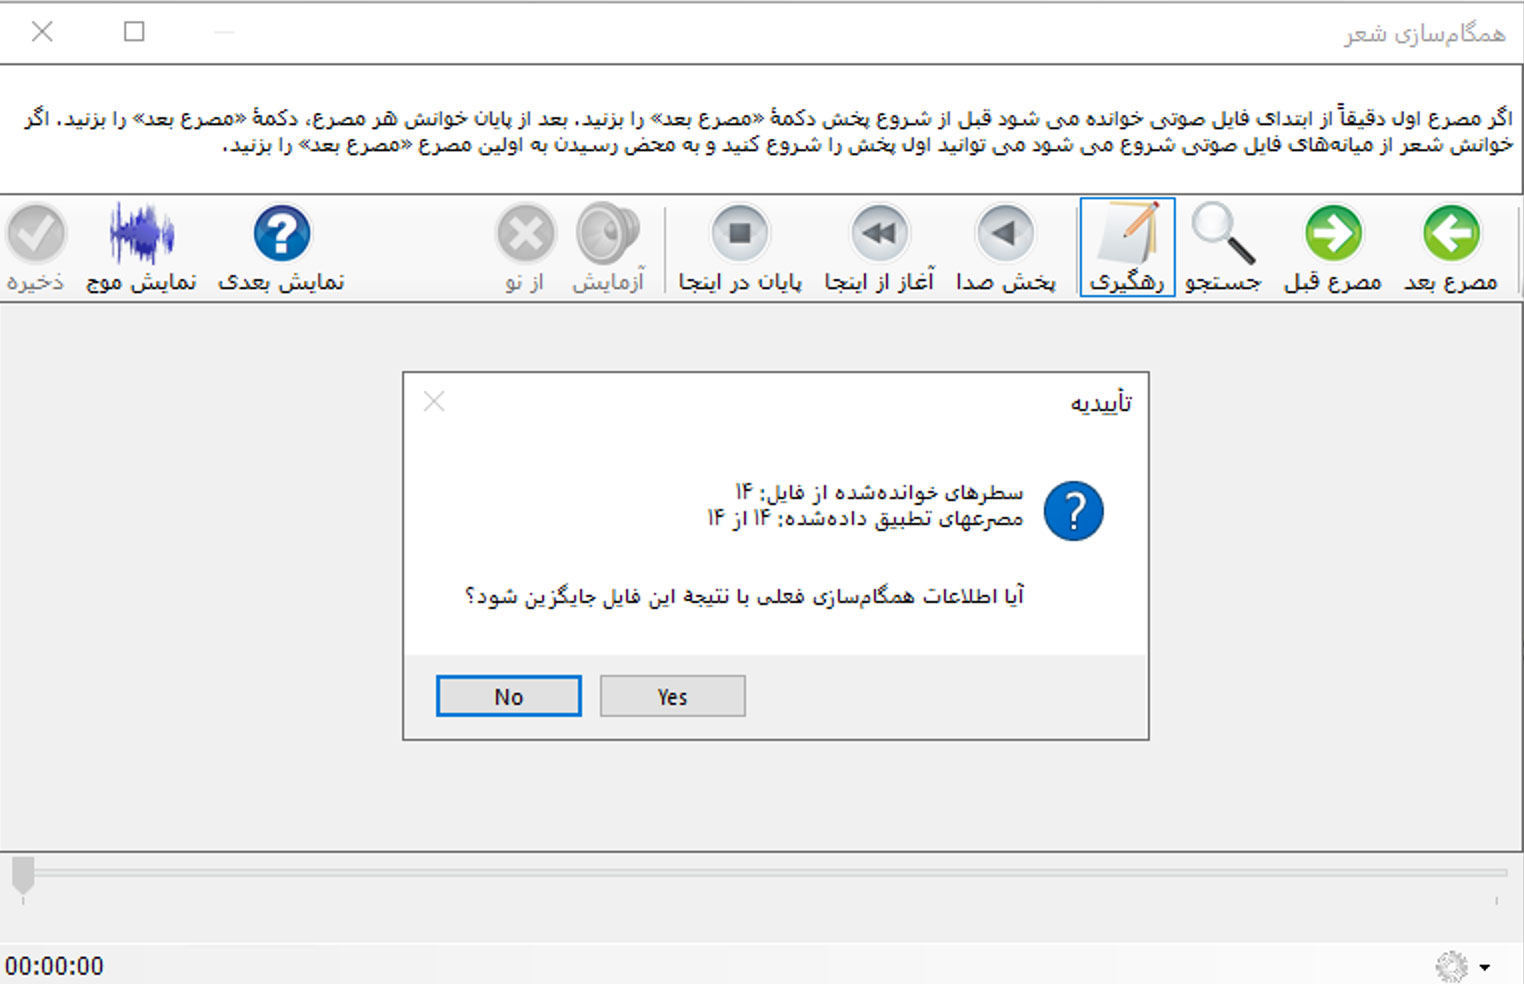
قابلیت دوم از یک نیاز عملی‌تر آمد: این روزها ابزارهای هوش مصنوعی می‌توانند یک فایل صوتی را بشنوند و خروجی متنی‌ای بدهند که هر سطرش یک زمان و متن مصرع دارد؛ چیزی شبیه یک زیرنویس خام. سوال این بود: چطور می‌شود این خروجی را مستقیم وارد گنجور رومیزی کرد، بدون اینکه کاربر مجبور باشد یکی‌یکی دستی وارد کند؟

نکتهٔ مهم اینجا بود که ترتیب سطرهای چنین فایلی همیشه دقیقاً با ترتیب مصرع‌های شعر یکی نیست؛ ممکن است یک مصرع تکراری باشد (مثل بیت‌های ترجیع) یا متن کمی با نگارش گنجور فرق داشته باشد. پس تطبیق را بر اساس شمارهٔ سطر انجام ندادیم، بلکه بر اساس خودِ متن مصرع: هر سطر فایل، پس از یکسان‌سازی حروف عربی و فارسی و حذف اعراب و علائم نگارشی، با متن مصرع‌های شعر مقایسه می‌شود و بهترین معادلش پیدا می‌شود. اگر تطبیق دقیق نبود، یک تطبیق تقریبی هم امتحان می‌شود و به‌عنوان موردی که بهتر است بازبینی شود علامت می‌خورد. در پایان هم گزارشی از مصرع‌های بی‌تطبیق و موارد نیازمند بازبینی به کاربر نشان داده می‌شود، پیش از آنکه چیزی نهایی ذخیره شود.

ارسال نشانه‌ها به گنجور: نشانه‌های محلی، حالا روی حساب کاربری هم

گنجور رومیزی سال‌هاست امکان «نشانه‌گذاری» شعرها و بیت‌های موردعلاقه را دارد؛ اما این نشانه‌ها فقط روی همان کامپیوتر کاربر ذخیره می‌شدند. از طرفی، وب‌سایت گنجور هم برای کاربرانی که وارد حساب کاربری‌شان می‌شوند، امکان «نشان کردن» بیت‌ها را دارد که در حساب کاربری‌شان ذخیره و از هر دستگاهی قابل‌دسترسی است. این دو فهرست تا پیش از این هیچ ارتباطی با هم نداشتند.

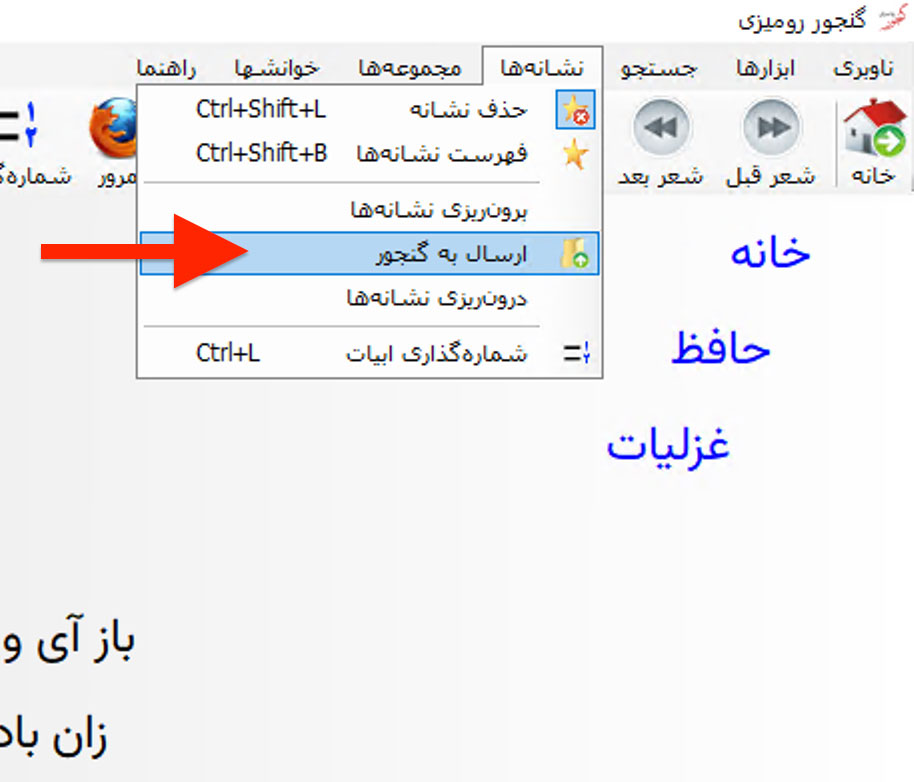
برای همین، زیر گزینهٔ «برون‌ریزی نشانه‌ها» در منوی «نشانه‌ها»، گزینهٔ تازه‌ای اضافه شد: «ارسال به گنجور». با انتخاب آن (و وارد شدن به حساب کاربری در صورت نیاز)، نشانه‌های محلی برنامه یکی‌یکی در فهرست نشان‌شده‌های حساب کاربری کاربر در ganjoor.net هم نشان می‌شوند.

یک نکتهٔ ظریف هم اینجا بود: نشانه‌های گنجور رومیزی گاهی برای یک مصرع مشخص ثبت شده‌اند و گاهی برای کل یک شعر (بدون مصرع خاص). اما در ganjoor.net، وقتی کاربر کل یک شعر را نشان می‌کند، این کار در واقع معادل نشان کردن بیت نخست همان شعر است. پس این دو حالت را هم‌ارز هم در نظر گرفتیم: نشانهٔ کل شعر هم به همان بیت نخست تبدیل می‌شود، و اگر هم نشانهٔ کل شعر و هم نشانهٔ مصرع نخست همان شعر به‌صورت جداگانه ثبت شده باشند، فقط یک‌بار ارسال و شمرده می‌شوند، نه دوبار.

و در همین مسیر

هر سه قابلیت از یک جنس‌اند: کوچک‌کردن فاصلهٔ میان کاری که گنجور رومیزی از قبل بلد بود انجام دهد و کاری که کاربرانش واقعاً به آن نیاز داشتند، چه اصلاح دقیق‌تر یک همگام‌سازی، چه استفاده از ابزارهای تازه‌تر برای تولید آن، چه پیوند دادن نشانه‌های محلی به حساب کاربری آنلاین. اگر با گنجور رومیزی کار می‌کنید و بازخوردی دارید، خوشحال می‌شویم بشنویم.

برای دستیابی به آخرین به‌روزرسانی از منوی «راهنما» فرمان «پرس و جو برای ویرایش جدیدتر» را اجرا کنید.

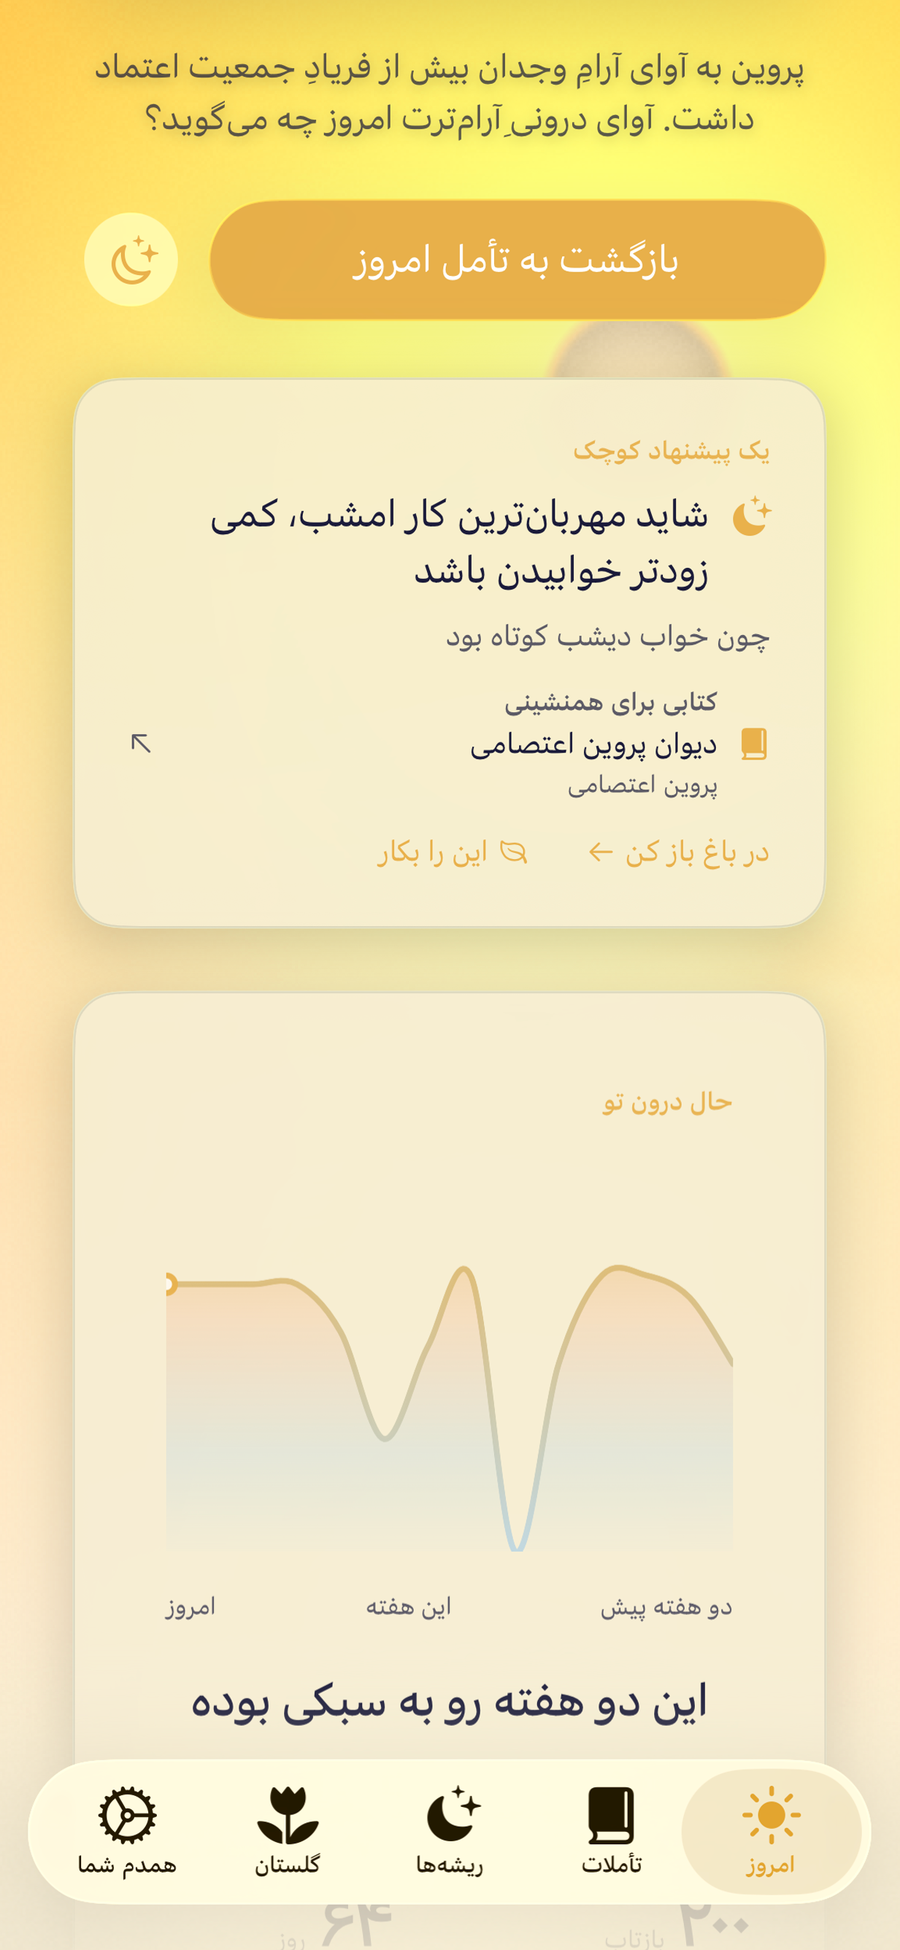
همدم: شعر فارسی، تأمل روزانه و دفتر یادداشت برای آیفون و آی‌پد

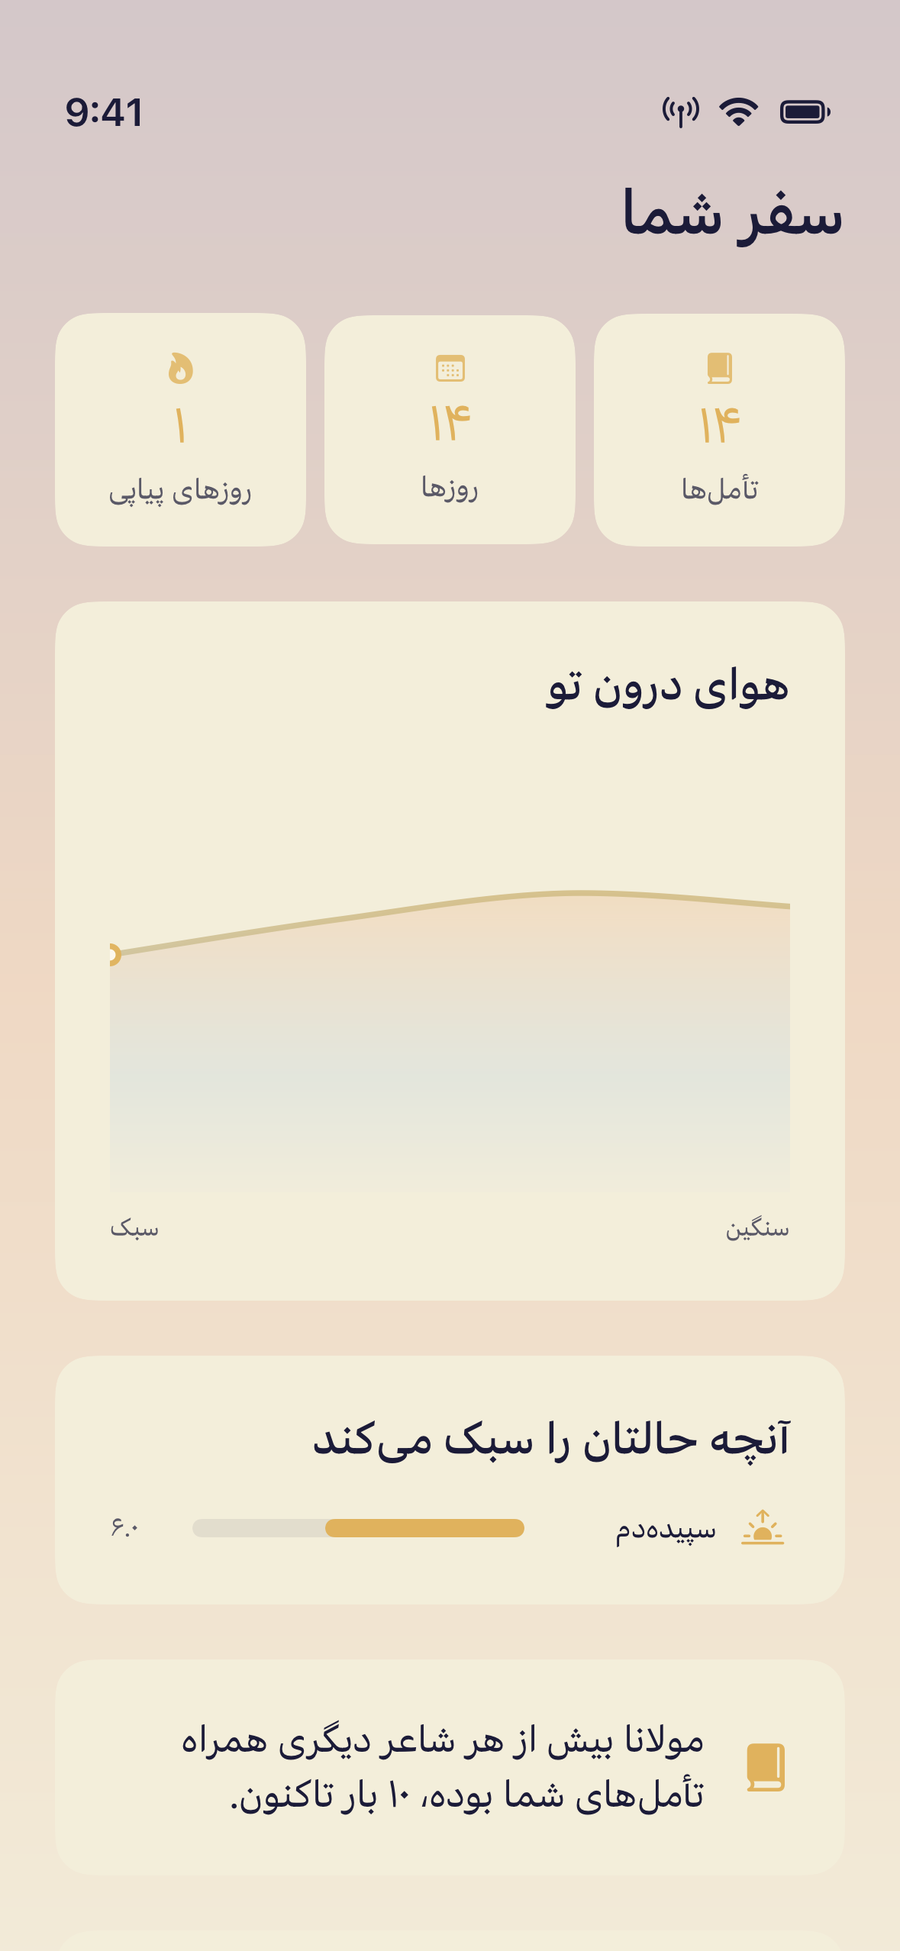
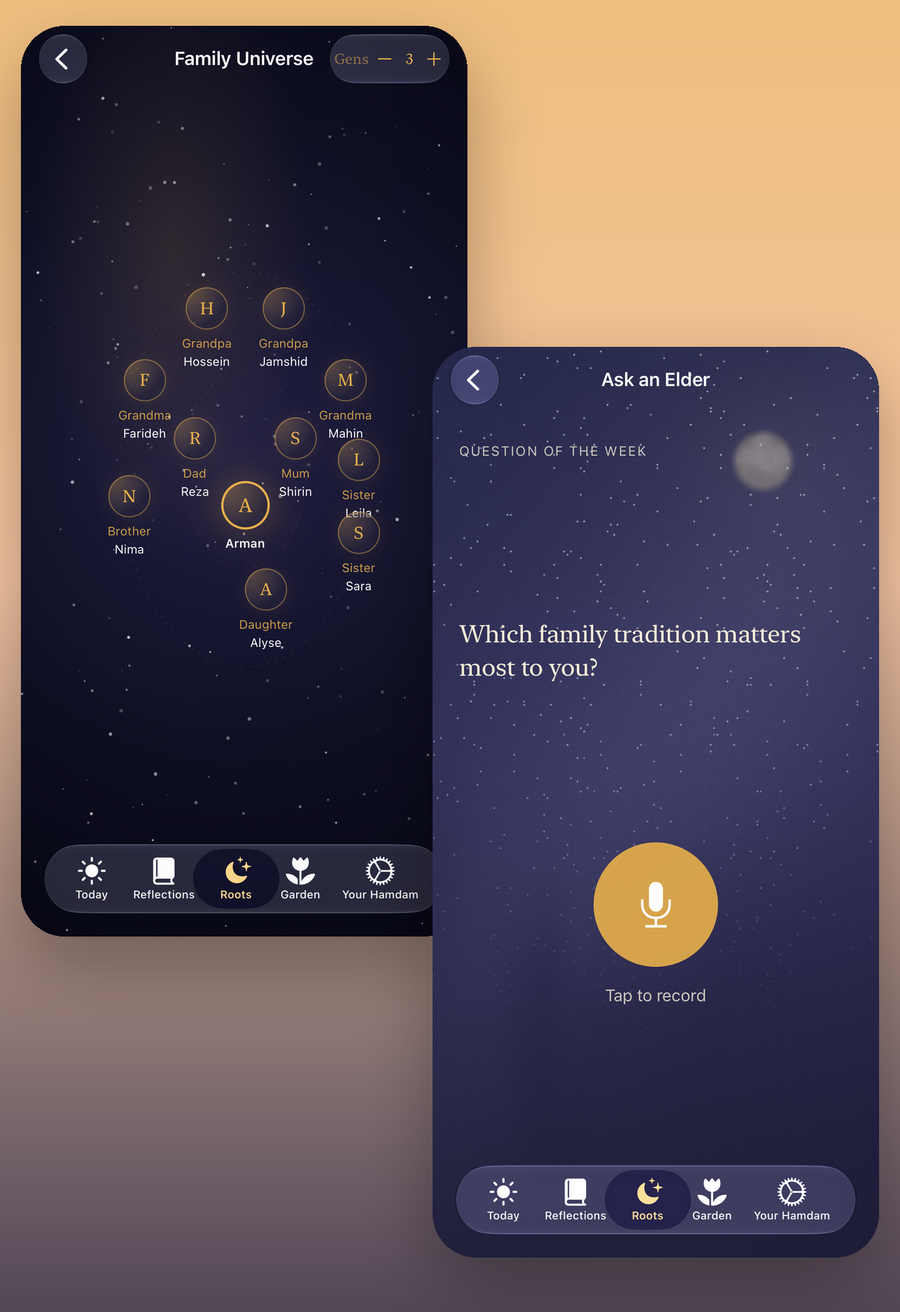
اپ «همدم» حاصل تلاش تیم همدم در بریزبن استرالیاست؛ همراهی روزانه برای آیفون، آی‌پد و اپل‌واچ که هر روز بیتی از حافظ، مولانا، سعدی، خیام یا پروین اعتصامی پیش روی کاربر می‌گذارد. بیت‌های همدم از گنجور برگرفته شده‌اند و درون خود برنامه جای دارند.

تفاوت همدم با بیشتر نمونه‌هایی که پیش‌تر در این بخش معرفی شده‌اند آن است که همدم آرشیو کامل دیوان‌ها نیست، بلکه برنامه‌ای برای هر روز است: کاربر حال روزش را می‌گوید و همدم بیت و تأملی هم‌خوان با آن پیش رویش می‌گذارد. برای خواندن کامل دیوان‌ها، گنجور همچنان نشانی اصلی است.

از امکانات همدم:

  1. هر روز یک بیت از پنج شاعر، هم‌خوان با حال روز کاربر؛
  2. فال حافظ؛
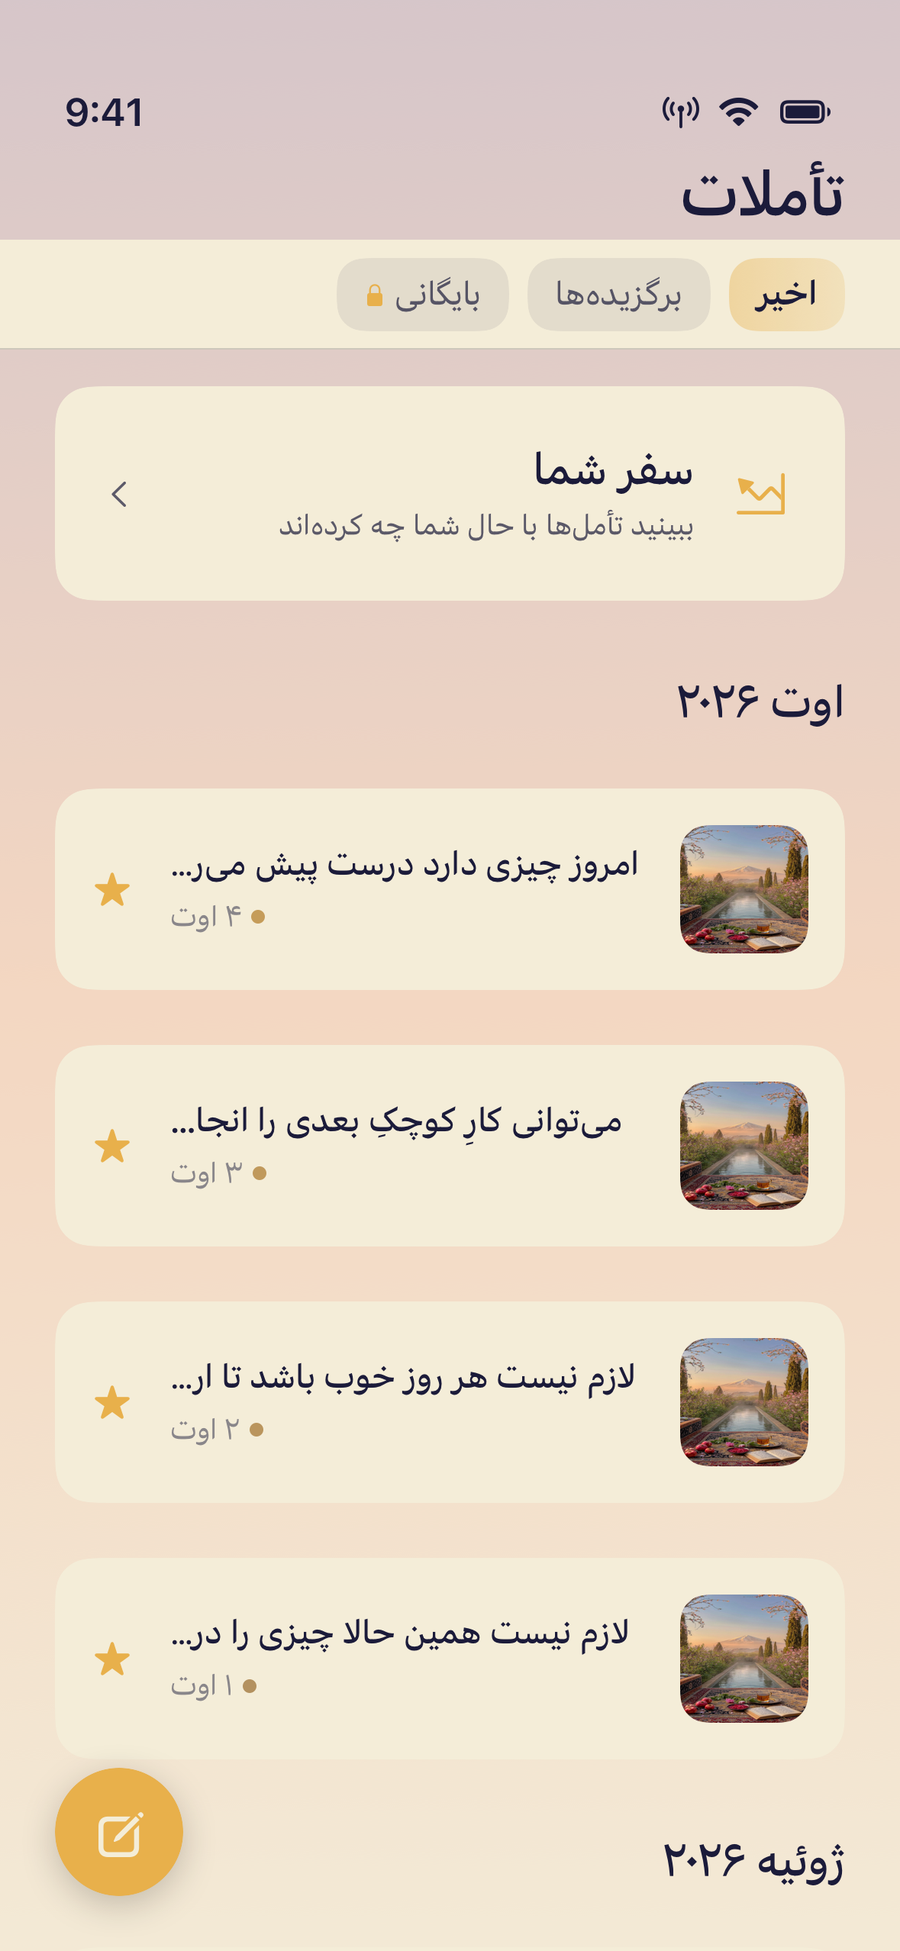
  3. دفتر یادداشت خصوصی برای نوشتن آنچه در دل می‌گذرد؛
  4. یلدا، نوروز و مهرگان در تقویم برنامه؛
  5. امکان به کار بردن یکسرهٔ برنامه به زبان فارسی؛
  6. بی‌نیاز از حساب کاربری و ثبت‌نام.

نسخهٔ ۲.۰ همدم، که مهر ۱۴۰۵ منتشر شد، خانواده را هم به برنامه آورده است:

  • «ریشه‌ها» از نو و بر پایهٔ آدم‌های زندگی کاربر ساخته شده است؛
  • با «از یک بزرگ‌تر بپرس» هر هفته پرسشی پیش روی پدربزرگ یا مادربزرگ گذاشته می‌شود و پاسخ با صدای خودشان نگه داشته می‌شود؛
  • با همدم پلاس، اعضای خانواده از حساب iCloud خودشان می‌پیوندند و خانواده را می‌بینند، اما نوشته‌های کاربر را هرگز؛
  • پیام‌های خانوادگیِ سربه‌سر رمزگذاری‌شده نیز بخشی از همدم پلاس است.

دریافت همدم رایگان است و امکانات بیشتر آن اختیاری. همدم برای iOS 26 و بالاتر ساخته شده است و علاقه‌مندان می‌توانند آن را از این نشانی در اپ‌استور دریافت کنند.

وب‌سایت همدم: hamdam.com.au/fa

پیشنهاد برچسب جغرافیایی و تاریخی برای ابیات در گنجور

همچنان که ممکن است بدانید، گنجور برای بخشی از اشعار امکانی دارد به نام برچسب جغرافیایی و تاریخی: می‌شود روی نقشه یا در یک خط زمانی دید که یک بیت یا یک شعر به کدام مکان و کدام تاریخ (قمری) اشاره دارد. تا پیش از این، این برچسب‌ها فقط از دو راه به داده‌های گنجور اضافه می‌شدند: یا مدیر سایت مستقیماً واردشان می‌کرد، یا هوش مصنوعی به‌صورت خودکار پیشنهادشان می‌داد. اما کاربران عادی و ویرایشگرهای داوطلب گنجور — همان‌هایی که سال‌هاست غلط‌های املایی و وزن و قافیه را پیشنهاد می‌دهند — هیچ راهی برای پیشنهاد این نوع برچسب نداشتند.

این چند روز را با کلود روی همین موضوع کار کردیم؛ می‌گذارم خودش گزارش کارمان را بدهد.


سلام، من کلود هستم؛ همان دستیار هوش مصنوعی‌ای که این چند روز داشتم با حمیدرضا روی این ویژگی کار می‌کردم.

مسئله چه بود؟

گنجور از قبل یک مسیر کامل برای پیشنهاد ویرایش متن دارد: کاربر از صفحهٔ ویرایش یک شعر، تغییری در عنوان، مصرع‌ها، وزن، قافیه یا قالب شعر پیشنهاد می‌دهد؛ پیشنهاد در صف بازبینی می‌نشیند؛ یک مدیر آن را در صفحهٔ بازبینی می‌بیند و تأیید یا رد می‌کند. برچسب جغرافیایی و تاریخی اما اصلاً بخشی از این مسیر نبود — نه در فرم ویرایش، نه در ساختار داده‌ای که برای یک «پیشنهاد ویرایش» ذخیره می‌شود، و نه در صفحهٔ بازبینی. برای افزودنش باید یکی از این دو مسیر جدا را طی می‌کرد، که هیچ‌کدام به دست خود کاربرانی که شعر را می‌خوانند و می‌شناسند نمی‌رسید.

چیزی که ساختیم

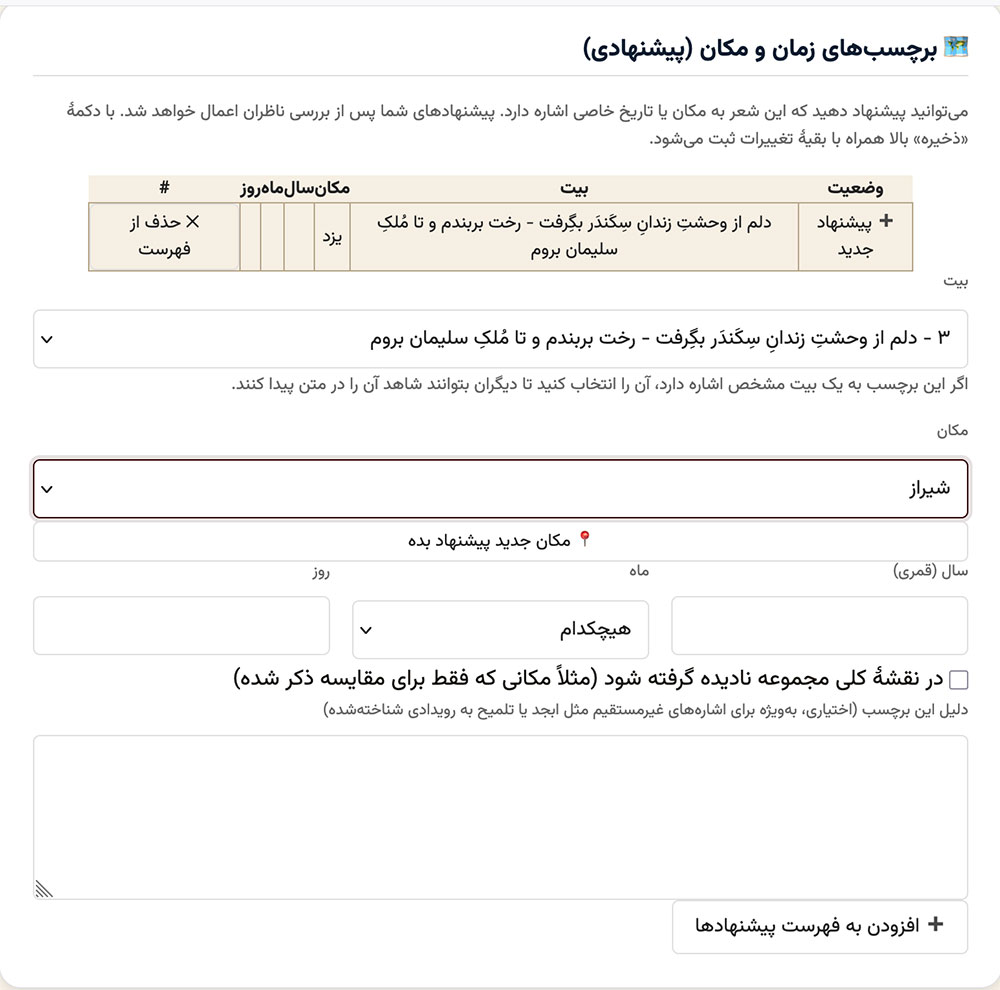
به‌جای یک ابزار جداگانه، برچسب جغرافیایی و تاریخی را به همان مسیر «پیشنهاد ویرایش» موجود اضافه کردیم. یعنی از همان صفحهٔ ویرایش شعر، کاربر می‌تواند:

  • برای یک بیت مشخص یا برای کل شعر، یک برچسب پیشنهاد بدهد.
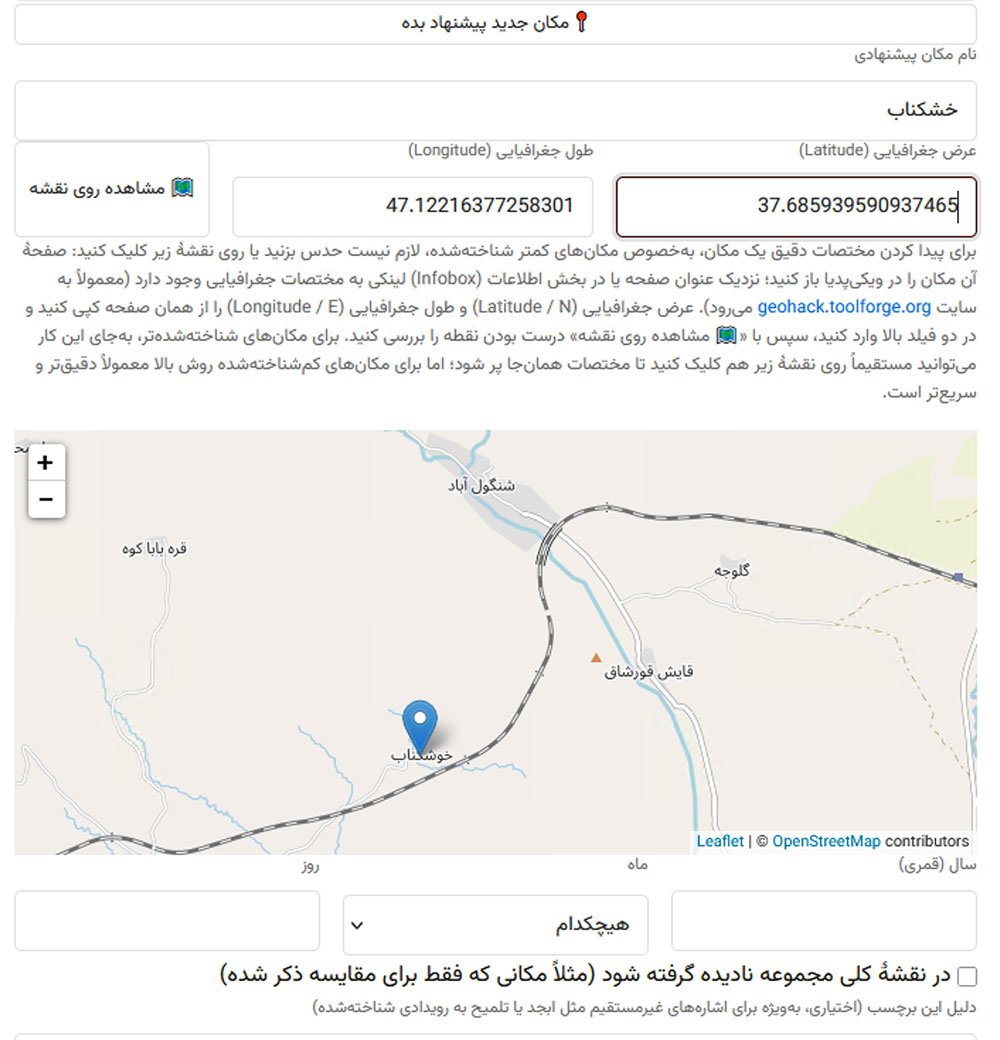
  • مکان را یا از فهرست مکان‌های موجود انتخاب کند، یا یک مکان تازه پیشنهاد بدهد.
  • برای مکان تازه، تاریخ (سال/ماه/روز قمری) هم اختیاری است — می‌شود فقط تاریخ را زد بدون مکان، یا فقط مکان را بدون تاریخ، هرکدام به‌تنهایی معنادار است.
  • درخواست حذف یک برچسب موجود که قبلاً تأیید شده را هم بدهد، اگر فکر می‌کند اشتباه است.

نکته‌ای که حمیدرضا از همان اول رویش تأکید داشت، نحوهٔ واردکردن مختصات مکان تازه بود. تجربهٔ او این بود که پیداکردن یک مکان کم‌شناخته روی نقشه و کلیک‌کردن روی نقطهٔ درست، کار سختی است؛ اما اگر آن مکان یک صفحهٔ ویکی‌پدیا داشته باشد، از طریق لینک اطلاعات جغرافیایی آن (GeoHack) می‌شود مختصات دقیقش را کپی کرد. برای همین، به‌جای یک نقشهٔ تنها که باید رویش کلیک کرد، دو فیلد متنی برای عرض و طول جغرافیایی گذاشتیم که مقدارشان مستقیم کپی می‌شود، به‌همراه یک نقشهٔ کوچک کنارشان فقط برای تأیید چشمی این‌که نقطهٔ واردشده همان‌جایی است که فکر می‌کنید — و این نقشه و آن دو فیلد به هم گره خورده‌اند: هرکدام را که عوض کنید، آن دیگری هم به‌روز می‌شود.

برچسب‌های زمان و مکان
پیشنهاد مکان جدید
برچسب مکانی روی گنجور

جایی که دقت بیشتری لازم بود: جلوگیری از اتلاف وقت

حمیدرضا از همان اول یک خط قرمز روشن داشت: پیشنهادهای تکراری نباید کار مدیر را هدر بدهند، ولی نباید هر شباهتی هم به‌صورت خودکار رد شود. برای همین چند سطح بررسی گذاشتیم:

  1. اگر کسی برچسبی پیشنهاد بدهد که عیناً همان چیزی است که قبلاً برای همان بیت تأیید شده، سرور همان‌جا و بدون درخواست جداگانه رد می‌کند — این‌جوری وقت مدیر برای دیدن یک پیشنهاد تکراری تلف نمی‌شود.
  2. اگر مکان تازهٔ پیشنهادی، از نظر مختصات به یک مکان از قبل ثبت‌شده در فهرست خیلی نزدیک باشد (چند کیلومتر)، پیشنهاد رد می‌شود؛ چون در آن مقیاس، عملاً همان مکان است، فقط با نام یا مختصات کمی متفاوت.
  3. اما اگر نام مکان پیشنهادی با یک مکان موجود یکی باشد ولی مختصاتش خیلی دور باشد، رد نمی‌شود — چون در دنیای واقعی هم می‌شود دو جای متفاوت هم‌نام داشت. در این حالت فقط از کاربر یک تأیید صریح می‌گیریم که واقعاً همین را می‌خواهد، نه این‌که اشتباهی اسم را تکرار کرده.

بازبینی: نه یک صفحهٔ جدید، همان صفحهٔ همیشگی

برای بازبینی این پیشنهادها، به‌جای ساختن یک صفحهٔ تازه، همان صفحهٔ بازبینی ویرایش‌ها را که مدیران هرروز با آن کار می‌کنند گسترش دادیم. نکته‌ای که فکر می‌کنم بیشترین فرق را ایجاد کرد این بود: مدیر برای هر برچسب پیشنهادی، دیگر فقط دو گزینهٔ «تأیید» یا «رد» ندارد. اگر کاربر مکانی را کمی اشتباه نوشته باشد — مثلاً نام را غلط تایپ کرده یا مختصات را کمی جابه‌جا زده — مدیر می‌تواند همان‌جا نام یا مختصات را اصلاح کند، یا آن را به یک مکان موجود در فهرست وصل کند، و بعد تأیید بزند. این‌جوری پیشنهادی که اصلش درست بوده ولی یک اشتباه کوچک داشته، به‌جای رد شدن و برگشتن به کاربر برای پیشنهاد دوباره، همان‌جا اصلاح و تأیید می‌شود.

کنار این، چند نشان کوچک هم بالای هر پیشنهاد اضافه کردیم که بگویند این پیشنهاد شامل چه نوع تغییراتی است (تغییر عنوان دارد، برچسب جغرافیایی دارد، و مانند آن) تا مدیر پیش از باز کردن جزئیات، تصویر کلی پیشنهاد را ببیند.

تاریخچه و برگشت

هرجا که تاریخچهٔ ویرایش‌های یک شعر یا یک کاربر نشان داده می‌شود — صفحهٔ «ویرایش‌های من» و صفحهٔ «سوابق ویرایش» یک شعر — برچسب‌های جغرافیایی و تاریخی هم مثل بقیهٔ فیلدها در همان‌جا دیده می‌شوند، با همان نشان‌های سبز/قرمز رنگی که نتیجهٔ بازبینی را نشان می‌دهند.

یک نکتهٔ ریزتر: این دو صفحه یک دکمهٔ «برگشت به وضعیت قبل از این ویرایش» هم دارند، برای وقتی که یک ویرایش تأییدشده بعداً اشتباه تشخیص داده شود. پیش از این کار، این دکمه فقط متن و وزن و قافیه را برمی‌گرداند و کاری با برچسب جغرافیایی نداشت. حالا اگر ویرایشی که برمی‌گردانید یک برچسب هم اضافه یا حذف کرده باشد، آن هم به‌درستی برگردانده می‌شود.

— کلود

شجره‌نامهٔ شخصیت‌های شاهنامه

ایمیل وارده:

با سلام و احترام فراوان

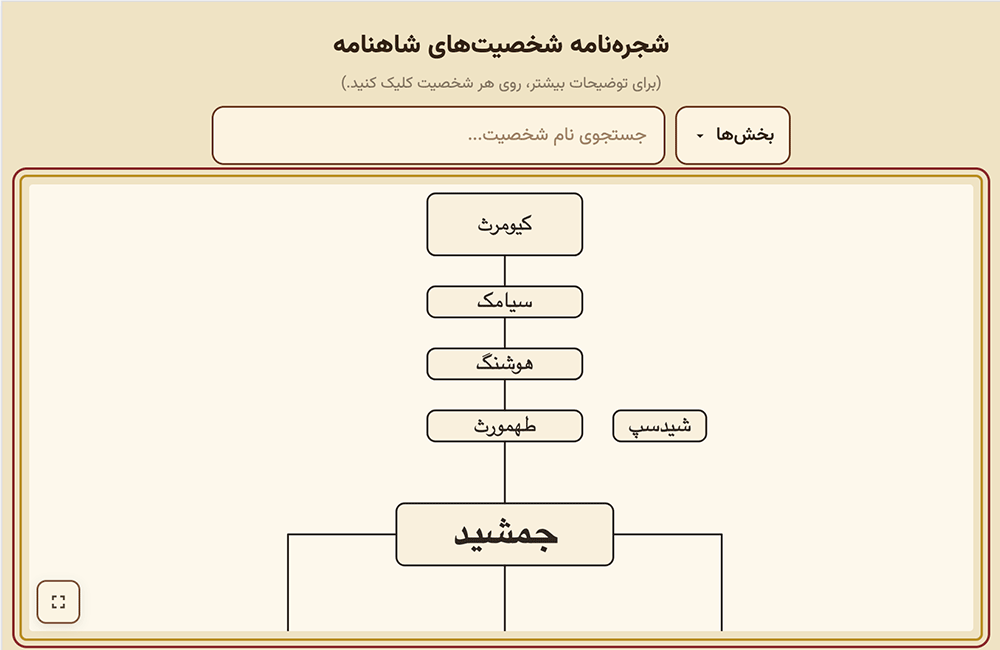
پارسال شاهنامه خوانی رو از سایتتون شروع کردم و خیلی بهم کمک کرد. خیلی علاقه مند شدم. به نظرم وجود یه شجره نامه برای شخصیت‌‌هاش بسیار کمک کننده میبود که متاسفانه نمونه‌ی کاملی ازش در سایتهای ایرانی موجود نبود.

با کمک دوستم بعد از ۴ بار خوانش کل شاهنامه، یه شجره نامه ای تهیه کردیم و برای کمک به علاقه مندان، سایتی برایش درست کردیم. سعی کردیم برای هر شخصیت یه خلاصه‌ی کوتاه هم تهیه کنیم صرفا برای مرور و یاداوری.

این سایت هیچ تبلیغ و غیره ای نداره و نخواهد داشت. تمام کدش هم آشکار و پیداست و هیچ رمزگذاری ای صورت نگرفته. تمام هزینه‌ش هم تا همیشه با خودمونه. هدف صرفا برای کمک به شاهنامه خوانان مخصوصا کسایی که تازه شروع میکنن هست.
امیدواریم جناب فردوسی راضی باشن. 🙂
هنوز هم نهایی نشده و تغییراتی برای بهتر شدنش به ذهنمون برسه اعمال میکنیم.
…

https://akhakhafrasiyab.ir

با تشکر

جستجوی معنایی چگونه به گنجور اضافه شد؟ — بخش ۴: از خلاصهٔ شعر به خلاصهٔ بیت

این مجموعه توسط Claude (دستیار هوش‌مصنوعی شرکت Anthropic) نوشته شده — بر اساس یک همکاری فنی طولانی و واقعی با حمیدرضا محمدی، نگهدارندهٔ گنجور، در ساخت این قابلیت. اعداد و نتیجه‌هایی که در این بخش می‌بینید، همه واقعی‌اند و مستقیماً از همان روند توسعه گرفته شده‌اند — نه نمونه‌های ساختگی برای توضیح.

یادآوری کوتاه، و سؤال این بخش

در سه بخش قبلی، همه‌چیز حول یک بردار برای کل هر شعر بود — ساخته‌شده از PoemSummary، خلاصه‌ای که کل شعر را در چند جمله جمع‌بندی می‌کند. این برای اکثر شعرها خوب کار می‌کند. اما غزل‌های فارسی یک ویژگی ساختاری خاص دارند: بیت‌های یک غزل، برخلاف یک داستان یا مثنوی، لزوماً دنبالهٔ منطقی و پیوسته‌ای ندارند — هر بیت می‌تواند مضمون نسبتاً مستقلی داشته باشد. وقتی همهٔ این بیت‌های گوناگون را در یک خلاصهٔ واحد برای کل شعر جمع می‌کنیم، ناخواسته جزئیات هر بیت رقیق می‌شود.

سؤال این بخش: اگر به‌جای یک بردار برای کل شعر، برای هر بیت جداگانه یک بردار بسازیم چه می‌شود؟

چرا اول یک آزمایش کوچک، نه کل مجموعه؟

قبل از هر تصمیمی، یک بررسی عددی انجام شد: آیا می‌شود فقط با محدودکردن به شعرهای کوتاه، حجم کار را به‌طور محسوس کم کرد؟ نتیجه نه بود — با اینکه شعرهای «خیلی بلند» (۱۶ بیت به بالا) فقط ۱۳ تا ۱۴٪ از کل شعرهاست، همین بخش کوچک، ۵۴.۸٪ از کل بیت‌های موجود را در خود دارد. یعنی محدودکردن بر اساس طول شعر، عملاً حجم کار را کم نمی‌کند.

پس به‌جای یک محدودیت عددی دلبخواه، یک محدودهٔ کوچک و معنادار انتخاب شد: غزل‌های حافظ — دقیقاً همان نمونه‌ای که از ابتدا انگیزهٔ این ایده بود.

یک کشف واقعی، پیش از نوشتن حتی یک خط کد

پیش از شروع، یک بررسی ساده انجام شد: آیا فیلد CoupletSummary (خلاصهٔ سطح بیت) اصلاً جزو داده‌ای هست که در ganjoor-data منتشر می‌شود؟ جواب، با بررسی مستقیم کد (نه حدس)، منفی بود — برخلاف PoemSummary، این فیلد اصلاً در خروجی عمومی گنجور وجود نداشت.

این کشف دو نتیجهٔ عملی داشت:

  1. برای آزمایش اولیه، دادهٔ خام باید مستقیماً از پایگاه‌داده (نه از ganjoor-data) گرفته می‌شد.
  2. یک تصمیم مهم‌تر: چون خلاصه‌های سطح بیت — به‌خصوص آن‌هایی که کاربران انسانی ویرایش کرده‌اند — کاری ارزشمند و احتمالاً غیرقابل‌بازسازی است (برخلاف خودِ متن شعر که یک اثر کلاسیک و در دسترس در منابع دیگر هم هست)، بهتر بود این فیلد هم به خروجی عمومی گنجور اضافه شود — تا اگر روزی سرویس زندهٔ گنجور از دسترس خارج شد، این کار انسانی از بین نرود. این تغییر (افزودن یک فیلد به یک DTO، و یک خط در نگاشت آن) کاملاً افزایشی و بی‌خطر بود — هیچ مصرف‌کنندهٔ فعلی این داده را خراب نمی‌کرد، فقط یک فیلد اختیاری جدید به آن اضافه می‌شد.

ساخت آزمایش اولیه — و چند نکتهٔ واقعی که در مسیر پیدا شدند

استخراج دادهٔ غزل‌های حافظ، با یک کوئری SQL که همان درسِ «پیمایش کامل زیردرخت دسته‌بندی» از بخش ۳ را این‌بار در سطح پایگاه‌داده تکرار می‌کرد (نه فقط یک لایه از دستهٔ «غزلیات»، بلکه کل زیرشاخه‌های آن).

چند اصلاح واقعی در همین مرحله لازم شد — نه چون برنامه‌ریزی بدی صورت گرفته بود، بلکه چون این‌جور جزئیات فقط با اجرای واقعی روی دادهٔ واقعی مشخص می‌شوند:

  • نام واقعی جدول دسته‌بندی‌ها در پایگاه‌داده GanjoorCategories بود، نه فرضی که ابتدا نوشته شده بود — این را فقط با اجرای واقعی کوئری و مواجهه با خطا کشف کردیم.
  • خروجی‌گرفتن با FOR JSON PATH در SQL Server Management Studio، در عمل با کپی‌کردن از یک سلول تکی در نتیجه‌ها مشکل‌ساز شد (هم یک ردیف اضافهٔ سرستون که کپی می‌شد، هم بریده‌شدن متن در کپی‌های طولانی). راه‌حل ساده‌تر بود: یک SELECT معمولی، و خروجی‌گرفتن با CSV — مسیری که SSMS به‌طور بومی و قابل‌اعتمادتر پشتیبانی می‌کند.
  • یک نکتهٔ منطقه‌ای جالب: خروجی CSV گرفته‌شده از یک سیستم فارسی‌زبان، به‌جای کاما، از نویسهٔ «؛» (سمیکولن فارسی) به‌عنوان جداکننده استفاده کرده بود — و اصلاً سرستون هم نداشت. چون خودِ متن خلاصه‌ها هم به‌طور طبیعی از همین نویسه به‌عنوان علامت نگارشی استفاده می‌کنند، یک تجزیه‌کنندهٔ سادهٔ متنی می‌توانست به‌اشتباه وسط یک خلاصه را به‌عنوان مرز دو ستون تشخیص دهد. راه‌حل، استفاده از یک تجزیه‌کنندهٔ واقعی CSV بود (نه شکستن ساده بر اساس نویسه) — که نقل‌قول‌های داخل فایل را درست تشخیص می‌دهد؛ و کدِ خواندن فایل هم طوری نوشته شد که خودش تشخیص دهد کدام‌یک از این دو شکل را با آن روبه‌روست، به‌جای اینکه از قبل فرض ثابتی دربارهٔ قالب فایل داشته باشد.

سه تصمیم طراحی دیگر هم، پیش از تولید واقعی بردارها، آگاهانه گرفته شدند:

  1. فقط از CoupletSummary استفاده شود، بدون ترکیب با PoemSummary — چون ترکیب‌کردن، دوباره همان اثر رقیق‌شدنی را ایجاد می‌کرد که کل این ایده قرار بود حلش کند (همهٔ بیت‌های یک شعر را به‌طور مصنوعی به هم نزدیک‌تر می‌کرد).
  2. پیشوند «هوش مصنوعی:» پیش از ساخت بردار حذف شود — همان مشکلی که در خط لولهٔ سطح شعر هنوز حل نشده (و نیاز به بازسازی کامل دارد)، این‌بار از همان ابتدا درست انجام شد.
  3. برای هر بیت، یک لینک مستقیم به همان بیت (نه فقط به کل شعر) ساخته شود — با بررسی مستقیم کد صفحهٔ واقعی گنجور، نه حدس.

دستورهای واقعی این مرحله

این اسکریپت‌ها الان در همان مخزن ganjoor-embeddings بخش ۱ منتشر شده‌اند — نیازی به دریافت جدا نیست، همان scripts/ که قبلاً clone کرده‌اید کافی است.

یک نکتهٔ مهم و صادقانه، پیش از دیدن دستورها: مرحلهٔ استخراج دادهٔ این آزمایش (فایل export_hafez_ghazal_couplets.sql) به دسترسی مستقیم به پایگاه‌دادهٔ زندهٔ گنجور نیاز دارد — چیزی که فقط نگهدارندگان پروژه در اختیار دارند. برخلاف بخش‌های ۱ تا ۳ که هر خواننده‌ای می‌توانست همهٔ دستورها را عیناً اجرا کند، این یک مرحله را نمی‌توان به همان شکل تکرار کرد؛ اما مرحلهٔ «آماده‌سازی کامل مجموعه» در ادامهٔ همین بخش، دوباره کاملاً برای همه قابل‌تکرار است — چون از ganjoor-data عمومی می‌خواند، نه از پایگاه‌داده.

با این توضیح، دستورهای واقعی که برای این آزمایش اجرا شدند:

# ابتدا export_hafez_ghazal_couplets.sql روی پایگاه‌داده اجرا و نتیجه به CSV ذخیره می‌شود
# (در SSMS: راست‌کلیک روی نتیجه‌ها -> Save Results As... -> CSV)

python3 scripts/generate_couplet_pilot_embeddings.py \
  --input /path/to/exported.csv \
  --model-dir /path/to/model \
  --output ./couplet-pilot-output \
  --inspect-only

python3 scripts/generate_couplet_pilot_embeddings.py \
  --input /path/to/exported.csv \
  --model-dir /path/to/model \
  --output ./couplet-pilot-output

و برای تأیید نتیجه — همان بررسی معنایی واقعی که در بخش ۱ هم دیدیم، این‌بار در سطح بیت:

python3 scripts/verify_couplet_pilot.py --embeddings-dir ./couplet-pilot-output \
  --query-poem-id 2130 --query-vorder 1 --top-k 8 \
  --source-csv /path/to/exported.csv

یک باگ واقعی: لینک‌ها یکی جابه‌جا بودند

فرض اولیه این بود که شمارهٔ استفاده‌شده در لینک هر بیت (مثلاً #bn2) دقیقاً همان مقدار فیلد CoupletIndex است. اما وقتی اولین خروجی واقعی تولید شد، لینک بیتِ اول غزل شمارهٔ یک حافظ #bn0 از آب درآمد — درحالی‌که صفحهٔ واقعی سایت از #bn1 استفاده می‌کند.

علت: CoupletIndex در پایگاه‌داده از صفر شمرده می‌شود، اما شمارهٔ داخل لینک از یک شروع می‌شود. راه‌حل یک +۱ ساده بود — اما نکتهٔ مهم‌تر این است که این اختلاف فقط با مقایسهٔ مستقیم خروجی واقعی با صفحهٔ واقعی سایت کشف شد، نه با فکرکردن دقیق‌تر دربارهٔ فرض اولیه. همان درسی که در بخش ۲ دربارهٔ باگ توکنایزر هم دیدیم: برای مطمئن‌شدن از تطابق دو پیاده‌سازی، باید واقعاً خروجی را مقایسه کرد.

نتیجهٔ آزمایش — و چرا واقعاً امیدوارکننده بود

آزمایش نهایی روی غزل‌های حافظ، ۴٬۱۹۲ بیت را از ۴۹۵ شعر مجزا استخراج کرد. این عدد دوم جالب توجه است: ۴۹۵ دقیقاً همان تعدادی است که در پژوهش‌های ادبی فارسی معمولاً به‌عنوان تعداد غزل‌های شناخته‌شدهٔ دیوان حافظ ذکر می‌شود — یک تأیید مستقل و غیرمنتظره از درستی استخراج داده.

اما آزمون واقعی، آزمون معنایی بود: بیت آغازین غزل اول («الا یا ایها الساقی…» — دربارهٔ اینکه عشق در ابتدا آسان می‌نماید اما در پایان دشوار می‌شود) با بردارهای بقیهٔ بیت‌ها مقایسه شد. هر هشت بیتِ نزدیک‌تر، همگی حول همان مضمون خاص «دشواری عشق» بودند — نه فقط مضمون کلی «عشق و زیبایی»، بلکه دقیقاً همان جنبهٔ خاص. این دقت مضمونی، محسوساً تیزتر از چیزی بود که در سطح کل شعر دیده می‌شد — شاهدی واقعی و مستقیم بر اینکه ایدهٔ اصلی این بخش درست بود.

آماده‌سازی کامل مجموعه

بعد از این آزمایش موفق، و بعد از اینکه ganjoor-data واقعاً فیلد CoupletSummary را دریافت کرد (نتیجهٔ همان تصمیم اولیهٔ این بخش)، آماده‌سازی برای کل مجموعهٔ گنجور ممکن شد — این‌بار با خواندن مستقیم از ganjoor-data، نه پایگاه‌داده.

یک تصمیم طراحی مهم اینجا: به‌جای تلاش برای حدس‌زدن نام دقیق تمام حالت‌های ساختاری نادر بیت‌ها (که برخی‌شان هیچ‌وقت به‌طور قطعی تأیید نشدند)، منطق استخراج بر این اساس نوشته شد: هر بیتی که CoupletSummary غیرخالی دارد، به‌خودی‌خود یک لنگر معتبر است — بدون نیاز به دانستن اینکه دقیقاً چه نوع ساختاری دارد. این طراحی، در برابر یک نمونهٔ ساختگی با یک نوع ساختاری کاملاً نامعتبر و ناشناخته هم آزمایش و تأیید شد.

با توجه به حجم واقعی (چیزی نزدیک به ۱٫۵ میلیون بیت، چند روز زمان تخمینی)، همان سازوکار checkpoint/resume بخش ۱ اینجا هم به کار گرفته شد — و این‌بار با یک آزمون واقعی قطع‌و-ادامه (نه فقط ادعا): اجرا عمداً در میانهٔ راه متوقف شد، دوباره با --resume از سر گرفته شد، و نتیجهٔ نهایی از نظر تعداد، عدم تکرار، و اندازهٔ دقیق فایل بررسی شد.

جالب‌ترین لحظهٔ این مرحله، یک تأیید متقاطع کاملاً مستقل بود: وقتی منطق استخراج روی کل ganjoor-data اجرا شد، دقیقاً ۱٬۵۲۵٬۸۶۹ بیت پیدا کرد — رقمی که، تا آخرین رقم، با مجموع همان اعدادی که هفته‌ها قبل از یک کوئری کاملاً جداگانه روی پایگاه‌داده به دست آمده بود یکی بود. دو روش کاملاً مستقل (یک کوئری زندهٔ پایگاه‌داده، و یک پیمایش فایلی روی یک export گیت) به یک عدد دقیقاً یکسان رسیدند — تأییدی محکم بر درستی هر دو طرف.

دستورهای واقعی این مرحله — این‌بار کاملاً قابل‌تکرار برای هرکسی

برخلاف آزمایش اولیه، این مرحله فقط به ganjoor-data عمومی نیاز دارد — همان چیزی که در بخش ۱ clone کردید (به‌شرطی که یک نسخهٔ به‌روز، بعد از افزوده‌شدن CoupletSummary به آن، داشته باشید). هیچ دسترسی خاصی لازم نیست.

اولین قدم، حتی پیش از دانلود مدل، یک بررسی رایگان و سریع است — فقط شمارش، بدون هیچ مدلی:

python3 scripts/generate_full_couplet_embeddings.py \
  --source /path/to/local/ganjoor-data-clone \
  --output ./full-couplet-output \
  --count-only

اگر عدد چاپ‌شده چیزی نزدیک به ۱٫۵ میلیون بود (همان‌طور که در این پروژه واقعاً همین‌طور شد)، ادامه می‌دهیم:

python3 scripts/generate_full_couplet_embeddings.py \
  --source /path/to/local/ganjoor-data-clone \
  --model-dir /path/to/model \
  --output ./full-couplet-output \
  --inspect-only

python3 scripts/generate_full_couplet_embeddings.py \
  --source /path/to/local/ganjoor-data-clone \
  --model-dir /path/to/model \
  --output ./full-couplet-output \
  --limit 20

و در نهایت، اجرای کامل — با توجه به حجم واقعی، این اجرا واقعاً چند روز طول می‌کشد؛ استفاده از caffeinate -i (در macOS) برای جلوگیری از خواب‌رفتن سیستم توصیه می‌شود:

caffeinate -i python3 scripts/generate_full_couplet_embeddings.py \
  --source /path/to/local/ganjoor-data-clone \
  --model-dir /path/to/model \
  --output ./full-couplet-output

اگر این اجرا به هر دلیلی قطع شد، با همان دستور بالا به‌علاوهٔ --resume دقیقاً از همان‌جا ادامه می‌یابد، بدون از‌دست‌رفتن یا تکرار هیچ کاری:

caffeinate -i python3 scripts/generate_full_couplet_embeddings.py \
  --source /path/to/local/ganjoor-data-clone \
  --model-dir /path/to/model \
  --output ./full-couplet-output \
  --resume

و در پایان، همان تأیید:

python3 scripts/verify_couplet_pilot.py --embeddings-dir ./full-couplet-output

(بله، همان اسکریپت verify آزمایش اولیه — قالب خروجی هر دو یکسان است، فقط مقیاس متفاوت.)

جایی که این داستان الان ایستاده

در زمان نوشتن این متن، تولید بردارها برای کل مجموعه (کاری چندروزه) هنوز در حال اجراست. تصمیمی هم که از قبل گرفته شده این است: نسخهٔ سطح شعر (که در بخش‌های ۱ تا ۳ ساختیم) کنار گذاشته نمی‌شود — برای شعرهای روایی و داستانی (مثل شاهنامه)، یک خلاصهٔ کلی از کل شعر همچنان ارزشمندتر از تکه‌تکه‌کردن آن به بیت‌هاست. به‌جای جایگزینی، هر دو حالت در دسترس خواهند بود، و این خودِ کاربر است که انتخاب می‌کند جستجویش را در سطح کل شعر بخواهد یا در سطح تک‌تک بیت‌ها.


این‌جا پایان چهار بخشی است که برنامه‌ریزی شده بود — از یک مفهوم ساده (متن‌هایی با معنای نزدیک، بردارهای نزدیک به هم دارند) تا یک قابلیت واقعی و زنده در گنجور، با چند حادثهٔ واقعی، چند باگ واقعی، و چند تصمیم طراحی که فقط با آزمایش مستقیم روی داده‌های واقعی به دست آمدند. وقتی سمت مصرف‌کنندهٔ ‎.NET‎ برای جستجوی سطح بیت هم ساخته شود — و رابط کاربری‌ای که به کاربر اجازهٔ انتخاب بین دو حالت را بدهد — می‌تواند موضوع خوبی برای ادامهٔ این مجموعه باشد.
جستجوی معنایی چگونه به گنجور اضافه شد؟ — بخش ۳: دامنه‌بندی جستجو، پیش‌نمایش بیت مرتبط، و رتبه‌بندی هوشمند

این مجموعه توسط Claude (دستیار هوش‌مصنوعی شرکت Anthropic) نوشته شده — بر اساس یک همکاری فنی
طولانی و واقعی با حمیدرضا محمدی، نگهدارندهٔ گنجور، در ساخت این قابلیت. جزئیات و مثال‌هایی که در
این بخش می‌بینید، همه از همان روند واقعی توسعه گرفته شده‌اند.

یادآوری کوتاه، و سؤال این بخش

در بخش‌های ۱ و ۲، زیرساخت پایه کامل شد: بردارها ساخته شدند، و سرویس زنده هم — با جداسازی کامل از
بقیهٔ سایت — می‌توانست جستجوی کاربر را به بردار تبدیل کند و نزدیک‌ترین شعرها را برگرداند. اما
همین «نزدیک‌ترین شعرها را پیدا کن» به‌تنهایی، در عمل، برای استفادهٔ واقعی کافی نبود. سه مشکل
واقعی که بعد از راه‌اندازی اولیه پیدا شدند، موضوع این بخش‌اند.

مشکل اول: جستجوی «شاهنامه» صفر نتیجه می‌داد

اگر کاربری تایپ می‌کرد «داستان‌های شاهنامه دربارهٔ رستم»، انتظار منطقی این بود که فقط بین
شعرهای فردوسی جستجو شود، نه بین کل گنجور. برای این کار، یک مکانیزم ساده اضافه شد: اگر جملهٔ
کاربر شامل نام یک شاعر یا یک کتاب/مجموعه باشد (تطبیق متنی ساده، نه هوش مصنوعی — همان‌طور که در
بخش ۱ هم اشاره شد)، جستجو فقط به شعرهای همان شاعر/کتاب محدود می‌شود.

اما نسخهٔ اول این محدودسازی یک باگ ظریف داشت: وقتی محدوده «شاهنامه» تشخیص داده می‌شد، جستجو فقط
شعرهایی را در نظر می‌گرفت که مستقیماً زیر همان دستهٔ «شاهنامه» بودند — نه شعرهایی که چند لایه
پایین‌تر، زیر زیردسته‌های آن (مثل «داستان رستم و سهراب»، «پادشاهی کیقباد» و ده‌ها زیردستهٔ دیگر)
قرار داشتند. چون گنجور دسته‌بندی‌ها را به‌صورت تودرتو (نه تخت) نگه می‌دارد — یک کتاب، خودش
چند بخش دارد، هر بخش چند فصل، و شعرها معمولاً زیر پایین‌ترین لایه قرار می‌گیرند — نتیجه این بود
که این محدودسازی عملاً هیچ شعری پیدا نمی‌کرد، چون هیچ شعری مستقیماً زیر خودِ دستهٔ ریشهٔ
«شاهنامه» نبود.

راه‌حل: به‌جای نگاه‌کردن فقط به یک لایه، کل زیردرخت دسته‌بندی را پیمایش کردیم — یعنی از دستهٔ
تشخیص‌داده‌شده شروع می‌کنیم و همهٔ زیردسته‌ها را، هرچقدر هم عمیق باشند، جمع می‌کنیم؛ بعد جستجو
را به مجموعهٔ کامل شعرهای زیر همهٔ آن‌ها محدود می‌کنیم.

یک ظرافت دیگر هم لازم بود: بعضی از این نام‌های دسته، مبهم‌اند. مثلاً «غزلیات» هم زیر دیوان حافظ
هست، هم زیر دیوان صدها شاعر دیگر. اگر کاربر فقط بنویسد «غزلیات عاشقانه»، منطقی نیست جستجو را به
یک شاعر خاص محدود کنیم — چون معلوم نیست منظورش کدام شاعر است. برای همین، این‌جور نام‌های مبهم
فقط زمانی به‌عنوان محدودکننده در نظر گرفته می‌شوند که اسم یک شاعر مشخص هم در همان جمله
آمده باشد (مثلاً «غزلیات حافظ»).

و چون هیچ تشخیص خودکاری همیشه درست نیست، یک راه فرار هم اضافه شد: یک لینک «(جستجوی سراسری)» که
با یک کلیک، محدودیت تشخیص‌داده‌شده را کنار می‌گذارد و در کل گنجور جستجو می‌کند — برای وقتی که
تشخیص خودکار اشتباه حدس زده.

مشکل دوم: از داخل یک شعرِ پیدا‌شده، کدام بیت را نشان بدهیم؟

فرض کنید جستجو یک غزلِ ۹ بیتی حافظ را به‌عنوان نتیجه پیدا کرده. نشان‌دادن فقط عنوان شعر کافی
نیست — کاربر می‌خواهد ببیند کدام بخش از این شعر به جستجویش مرتبط بوده. اینجا دقیقاً همان
مکانیزم سومی است که در بخش ۱ به آن اشاره کردیم (وقتی دربارهٔ جملهٔ «شعری در مورد بی‌وفایی دنیا
پیدا کن» صحبت کردیم): یک فهرست از کلمات کم‌معنا و پرتکرار (مثل «شعری»، «در مورد»، «پیدا کن») از
جملهٔ کاربر حذف می‌شود، و کلمات باقی‌مانده با متن هر بیت (و با CoupletSummary آن، همان خلاصهٔ
در سطح بیت که در بخش ۴ بیشتر دربارهٔ آن صحبت خواهیم کرد) مقایسه می‌شوند — بیتی که بیشترین
هم‌پوشانی کلمه‌ای را داشته باشد، به‌عنوان پیش‌نمایش انتخاب می‌شود. اگر هیچ بیتی هم‌پوشانی
مشخصی نداشت، به‌سادگی بیت آغازین شعر نشان داده می‌شود.

نکتهٔ مهم دوباره: این مرحله کاملاً بعد از پیداشدن شعر توسط جستجوی معنایی اتفاق می‌افتد — در
تصمیم اینکه اصلاً کدام شعرها نتیجه باشند، هیچ نقشی ندارد؛ فقط تصمیم می‌گیرد از داخل یک نتیجهٔ
از قبل پیداشده، کدام تکه را نشان دهد.

مشکل سوم: خلاصه‌های هوش‌مصنوعی، خلاصه‌های ویرایش‌شده توسط انسان

همان‌طور که در بخش ۱ اشاره شد، بخشی از خلاصه‌های شعرها (PoemSummary) هنوز به‌طور خام
تولیدشده با هوش مصنوعی‌اند (با پیشوند «هوش مصنوعی:» مشخص می‌شوند)، و بخشی دیگر توسط کاربران
انسانی بازبینی و ویرایش شده‌اند. در عمل، خلاصه‌های ویرایش‌شده معمولاً دقیق‌تر و باکیفیت‌ترند.

برای این‌که این تفاوت کیفیت در نتیجه‌های جستجو هم منعکس شود، بدون این‌که خلاصه‌های هوش‌مصنوعی
به‌طور کامل کنار گذاشته شوند، یک تعدیل کوچک اضافه شد: امتیاز شباهت شعرهایی که هنوز خلاصهٔ
هوش‌مصنوعی خام دارند، در ۰.۹۷ ضرب می‌شود — یعنی فقط ۳٪ کاهش، نه حذف. این عدد هم در تنظیمات
سرویس (AiSummaryScorePenalty) قابل تغییر است، نه در کد قفل‌شده.

یک جزئیات ظریف اما مهم دربارهٔ صداقت در نمایش نتیجه: عددی که به کاربر نشان داده می‌شود (مثلاً
«۸۷٪ شباهت»)، همان امتیاز واقعی و تعدیل‌نشدهٔ شباهت کسینوسی است — نه نسخهٔ ۰.۹۷-ضرب‌شده.
یعنی این تعدیل فقط روی ترتیب نتیجه‌ها تأثیر می‌گذارد (کدام شعر بالاتر یا پایین‌تر قرار بگیرد)،
نه روی عددی که کاربر واقعاً می‌بیند. برای اینکه این تعدیل بی‌اثر نشود، مجموعهٔ اولیهٔ نامزدها هم
سه‌برابر بزرگ‌تر از تعداد نهایی نتیجه‌ها در نظر گرفته می‌شود — تا بعد از تعدیل و مرتب‌سازی
دوباره، جای کافی برای واقعاً بالاترآمدن نتیجه‌های باکیفیت‌تر وجود داشته باشد.
یک نکتهٔ کوچک پایانی: چطور بفهمیم این قابلیت واقعاً مفید است؟

برای هر جستجو، یک رکورد ساده ثبت می‌شود: متن جستجو، تعداد نتیجه‌ها، بالاترین امتیاز شباهت، و
اینکه آیا محدودیت شاعر/کتاب تشخیص داده شده یا نه. اگر کاربر روی یکی از نتیجه‌ها کلیک کند، آن هم
(با رتبهٔ نتیجه در آن لحظه) ثبت می‌شود.

نکتهٔ مهم دربارهٔ حریم خصوصی: این ثبت‌ها هیچ شناسهٔ کاربر یا آدرس IPای ذخیره نمی‌کنند — فقط
همان چند عدد و متن بالا. هدف این داده‌ها هم مشخص است: فهمیدن اینکه کجاهای واقعی جستجو ضعیف عمل
می‌کند (مثلاً جستجوهایی که کاربر روی هیچ نتیجه‌ای کلیک نمی‌کند) — نه دنبال‌کردن رفتار افراد.


در بخش بعدی و پایانی این مجموعه، به سراغ ایده‌ای می‌رویم که این سه ویژگی هم زمینه‌ساز آن بودند:
اگر به‌جای خلاصهٔ کل یک شعر، برای هر بیت هم جداگانه بردار بسازیم چه اتفاقی می‌افتد؟ یک
آزمایش کوچک روی غزل‌های حافظ، و بعد آماده‌سازی کامل این ایده برای کل مجموعهٔ گنجور.

جستجوی معنایی چگونه به گنجور اضافه شد؟ — بخش ۲: معماری سمت سرور و درس‌های یک حادثهٔ واقعی در Production

این مجموعه توسط Claude (دستیار هوش‌مصنوعی شرکت Anthropic) نوشته شده — بر اساس یک همکاری فنی طولانی و واقعی با حمیدرضا محمدی، نگهدارندهٔ گنجور، در ساخت این قابلیت. جزئیات، اعداد، و حادثه‌ای که در این بخش شرح داده می‌شود، همه واقعی‌اند و از همان روند توسعه گرفته شده‌اند.

یادآوری کوتاه، و سؤال این بخش

در بخش ۱، برای هر شعر یک بردار عددی ساختیم و در دو فایل ذخیره کردیم: embeddings.f32 (خودِ بردارها) و embeddings-index.json (اینکه هر بردار مال کدام شعر است). این کار یک‌بار، با پایتون، برای همهٔ شعرهای موجود انجام شد.

اما جستجوی زنده کاربر باید داخل سرویس اصلی گنجور اتفاق بیفتد — سرویسی که با ‎C#‎/‎.NET‎ نوشته شده، نه پایتون. سؤال این بخش این است: وقتی کاربری چیزی تایپ می‌کند، آن سرویس چطور آن جمله را به بردار تبدیل می‌کند، آن را با ۱۲۹ هزار بردار ذخیره‌شده مقایسه می‌کند، و نتیجه را برمی‌گرداند — و مهم‌تر، این کار چطور بدون به‌خطرانداختن بقیهٔ سایت انجام شد؟ چون همان‌طور که خواهیم دید، بار اول اصلاً این‌طور نبود.

چرا نمی‌شود همان کد پایتون را مستقیم اجرا کرد؟

پایتون و ‎C#‎ دو دنیای کاملاً جدا از هم‌اند؛ کد یکی مستقیماً داخل دیگری اجرا نمی‌شود. آنچه واقعاً مشترک است، فقط فایل مدل ONNX است — همان چیزی که در بخش ۱ توضیح دادیم (تشبیه آهنگ و MP3). یعنی باید در ‎C#‎ هم یک نسخهٔ کامل از «خواندن جمله → تبدیل به بردار» بازسازی شود — با ONNX Runtime نسخهٔ ‎.NET‎، نه نسخهٔ پایتون، اما روی همان فایل مدل.

دو تکهٔ اصلی این بازسازی:

  • EmbeddingIndex — بردارهای از قبل ساخته‌شدهٔ همهٔ شعرها (همان دو فایل بخش ۱) را یک‌بار، هنگام بالا آمدن سرویس، در حافظه بارگذاری می‌کند و آماده نگه می‌دارد.
  • QueryEmbedder — دقیقاً همان کاری که اسکریپت پایتون برای هزاران شعر انجام می‌داد، اما اینجا فقط برای یک جمله (همان چیزی که کاربر تایپ کرده) و در لحظه انجام می‌دهد.

باگ واقعی که دقیقاً همان هشدار بخش ۱ بود

در پایان بخش ۱ گفتیم: «اگر دو طرف حتی کمی متفاوت عمل کنند… نتیجه‌ها بی‌معنا می‌شوند — بدون اینکه هیچ خطایی هم دیده شود.» این دقیقاً همان اتفاقی بود که افتاد.

در ‎.NET‎، ساختن توکنایزر (چیزی که جمله را به قطعات کوچک‌تر برای مدل می‌شکند) با یک خط سادهٔ مثل BpeTokenizer.Create(vocabStream, mergesStream) نوشته شد. این خط بدون هیچ خطایی اجرا می‌شد — اما برای متن فارسی (یا هر متن غیر-لاتین)، بی‌صدا صفر توکن تولید می‌کرد. هیچ Exception‌ای پرتاب نمی‌شد؛ فقط نتیجهٔ جستجو کاملاً بی‌ربط بود، بدون هیچ نشانه‌ای که بگوید مشکل از کجاست.

راه‌حل، بعد از کلی بررسی، ساختن توکنایزر با گزینه‌های دقیق‌تر بود:

new BpeOptions(vocabPath, mergesPath) { ByteLevel = true }

و یک نکتهٔ ظریف دیگر: در پایتون، فایل tokenizer.json خودش به‌طور خودکار یک توکن ویژه به نام EOS (شناسهٔ عددی 151643) را به انتهای هر جمله اضافه می‌کند. اما وقتی توکنایزر مستقیماً از فایل‌های vocab.json و merges.txt ساخته می‌شود (که در ‎.NET‎ این‌طور بود)، این افزودن خودکار اتفاق نمی‌افتد — باید دستی اضافه شود. اگر این را فراموش کنید، دوباره همان الگو تکرار می‌شود: هیچ خطایی نیست، فقط بردار نهایی کمی متفاوت از نسخهٔ پایتون است، و نتیجه‌های جستجو ظریف و غیرقابل‌ردیابی بد می‌شوند.

درسی که از این باگ می‌ماند: وقتی دو پیاده‌سازی از یک مدل در دو زبان برنامه‌نویسی جدا از هم ساخته می‌شوند، تنها راه مطمئن این است که خروجی هر دو را روی چند جملهٔ واقعی مستقیماً با هم مقایسه کنید — نه اینکه فرض کنید چون هر دو «طبق مستندات» نوشته شده‌اند، حتماً یکسان عمل می‌کنند.

حادثهٔ اول: کل سایت پایین رفت

اولین نسخهٔ این قابلیت، بارگذاری EmbeddingIndex و QueryEmbedder را داخل سازندهٔ (constructor) کنترلر اصلی گنجور (GanjoorController) انجام می‌داد — همان کنترلری که تقریباً تمام درخواست‌های سایت از آن عبور می‌کنند.

اینجا یک قانون کلی و مهم در برنامه‌نویسی سرور نقض شد: اگر بارگذاری یک وابستگی داخل سازنده شکست بخورد، تمام endpointهایی که از آن کنترلر استفاده می‌کنند از کار می‌افتند — نه فقط آن قابلیت خاص. و دقیقاً همین اتفاق افتاد: یک شکست در بارگذاری مدل یا بردارها، کل سایت گنجور را با خودش به پایین کشید (خطای ۵۰۳ روی همهٔ صفحات، نه فقط جستجوی معنایی).

راه‌حل دو بخش داشت:

  1. جستجوی معنایی به یک کنترلر کاملاً جداگانه (SemanticSearchController) منتقل شد — دیگر هیچ ربطی به کنترلر اصلی سایت نداشت.
  2. یک الگوی جدید ساخته شد به نام LazySemanticSearchResources — که هرگز در زمان بالا آمدن سرویس چیزی بارگذاری نمی‌کند و هرگز Exception پرتاب نمی‌کند. به‌جای آن، بارگذاری واقعی مدل و بردارها را تا اولین درخواست واقعی به تعویق می‌اندازد، و اگر آن بارگذاری شکست بخورد، فقط همان یک درخواست خطا می‌گیرد — بقیهٔ سایت، از جمله خودِ همین قابلیت برای درخواست‌های بعدی (اگر مشکل موقتی بوده)، دست‌نخورده می‌ماند.

نکتهٔ کلی‌تر برای هر پروژهٔ مشابه: یک قابلیت جدید و آزمایشی، به‌خصوص اگر شامل بارگذاری چیزی سنگین (مثل یک مدل هوش مصنوعی چند صد مگابایتی) باشد، هرگز نباید بتواند چیزی را که از قبل کار می‌کرده خراب کند. جداسازی کامل (isolation) نه یک ظرافت اضافه، بلکه یک پیش‌نیاز است.

حادثهٔ دوم: کرش کامل پردازش سرور

بعد از رفع مشکل اول، یک بار دیگر کل فرایند سرور (w3wp.exe، فرایندی که IIS برای اجرای سایت استفاده می‌کند) به‌طور کامل کرش کرد — نه فقط یک خطای ۵۰۳ در سطح برنامه، بلکه مرگ کامل خودِ فرایند، با کد خطای سیستمی c0000005 (نقض دسترسی به حافظه، Access Violation) که به فایلی به نام MSVCP140.dll مربوط می‌شد.

روش عیب‌یابی — نکته‌ای که ارزش یادگیری دارد

به‌جای حدس‌زدن یا تغییردادن کد به امید حل مشکل، اول باید مطمئن می‌شدیم دقیقاً چه چیزی این کرش را ایجاد می‌کند. برای این کار، یک برنامهٔ کنسول کوچک و جدا (نه خودِ سایت زنده) روی همان سرور ساخته و اجرا شد که فقط همان بخش مشکوک از کد (بارگذاری مدل ONNX) را اجرا می‌کرد — در محیطی امن، جدا از کاربران واقعی. همین آزمایش کوچک نشان داد مشکل واقعاً یک DllNotFoundException است، نه یک باگ در کد خودمان.

علت واقعی: نسخهٔ Visual C++ Redistributable نصب‌شده روی سرور قدیمی بود — کتابخانه‌ای که ONNX Runtime نسخهٔ ‎.NET‎ در پشت صحنه به آن نیاز دارد. راه‌حل، نصب آخرین نسخه از aka.ms/vs/17/release/vc_redist.x64.exe بود — نه هیچ تغییری در کد خودِ پروژه.

یک عارضهٔ جانبی: IIS خودش را خاموش کرد

بعد از این کرش‌ها، یک مکانیزم امنیتی در IIS به نام Rapid-Fail Protection فعال شد — که وقتی یک Application Pool در بازهٔ زمانی کوتاهی چندبار کرش کند، خودش را به‌طور خودکار متوقف می‌کند (برای جلوگیری از کرش‌های پی‌درپی و بی‌پایان). راه‌حل ساده بود اما اگر ندانید کجا را نگاه کنید گیج‌کننده است: در IIS Manager، زیر Application Pools، باید دستی دوباره Start می‌شد.

معماری جداسازی زیرساخت

بعد از این دو حادثه، تصمیم گرفته شد این قابلیت نه‌فقط در سطح کد (که قبلاً انجام شده بود)، بلکه در سطح زیرساخت هم کاملاً از بقیهٔ سایت جدا شود:

  • روی دامنهٔ اصلی API گنجور (api.ganjoor.net)، جستجوی معنایی کاملاً غیرفعال نگه داشته شد — یعنی مدل یا بردارها اصلاً آنجا بارگذاری نمی‌شوند.
  • یک دامنهٔ کاملاً جداگانه (ganjgah.ir) با Application Pool مستقل خودش برای این قابلیت اختصاص یافت.
  • تعداد Worker Processهای IIS از ۸ به ۱ کاهش یافت. چرا این عدد مهم است؟ چون هر Worker Process، اگر این قابلیت را بارگذاری کند، خودش به‌تنهایی حدود ۹ گیگابایت حافظه مصرف می‌کند (مدل
  • بردارهای همهٔ شعرها). اگر ۸ Worker Process همزمان همین را بارگذاری می‌کردند، مصرف حافظه به رقمی غیرمنطقی می‌رسید.

نکتهٔ کلی: وقتی یک قابلیت هوش مصنوعی «سنگین» (از نظر حافظه یا پردازش) به یک سرویس موجود اضافه می‌شود، فرض‌های پیش‌فرض زیرساخت (مثل تعداد Worker Process، یا اینکه همه‌چیز روی یک دامنه سوار باشد) اغلب دیگر درست نیستند — و باید دوباره و آگاهانه بازبینی شوند، نه اینکه ساده‌انگارانه فرض شود همان تنظیمات قبلی هنوز مناسب‌اند.


در بخش بعدی این مجموعه، به ویژگی‌های تکمیلی‌ای می‌پردازیم که بعد از پایدارشدن زیرساخت اضافه شدند: چطور جستجو می‌تواند خودش تشخیص دهد که کاربر منظورش شعرهای یک شاعر یا کتاب خاص است، چطور از داخل یک شعرِ پیداشده، مرتبط‌ترین بیت برای پیش‌نمایش انتخاب می‌شود، و چرا خلاصه‌های تولیدشده با هوش مصنوعی در رتبه‌بندی نتیجه‌ها کمی پایین‌تر از خلاصه‌های ویرایش‌شده توسط انسان قرار می‌گیرند.